نُشرت يوم 27 أغسطس 2026 واحدة من أهم الإجابات العلمية حتى الآن عن السؤال الذي يشغل كل طالب وأستاذ وولي أمر: هل استخدام ChatGPT في المهام الدراسية يقتل التفكير الناقد، أم يرفع مستوى العمل؟ التجربة العشوائية أجراها باحثون من جامعة بوككوني الإيطالية بالتعاون مع فريق الأبحاث الاقتصادية في OpenAI على 1,053 طالباً من السنة الأولى، ونشرت نتائجها OpenAI في تدوينة بحثية بعنوان «إجابات أفضل وتفكير أوسع: ما الذي يكسبه الطلاب من ChatGPT والتدريب على التفكير الناقد»، مع الورقة البحثية الكاملة المتاحة للعموم. الخلاصة المختصرة مفاجئة بطريقتين: ChatGPT رفع تقييم أعمال الطلاب بما يقارب نقطة كاملة من خمس، بينما التدريب على التفكير الناقد لم يرفع الدرجة إطلاقاً — لكنه فعل شيئاً آخر أهم على المدى الطويل. في هذا المقال نشرح التجربة بالتفصيل، ونضع الأرقام أمامك، ونقول بصراحة ما الذي تثبته وما الذي لا تستطيع إثباته، وماذا يعني كل هذا لك كطالب عربي تستخدم هذه الأدوات يومياً. (آخر تحديث: 31 أغسطس 2026)
ماذا حدث بالضبط؟ تصميم تجربة نُفذت داخل قاعات الدرس
البحث الذي صدر في أغسطس 2026 بعنوان «تدريب المبتدئين على التفكير، أم منحهم نماذج لغوية كبيرة؟ دليل من تجربة عشوائية» ليس استبياناً ولا مقالاً رأياً، بل تجربة عشوائية مضبوطة (RCT) مسجَّلة مسبقاً — أي أن الباحثين ثبّتوا خطة القياس قبل جمع البيانات لمنع انتقاء النتائج لاحقاً. نفِّذت التجربة في نوفمبر 2025 على 1,053 طالباً من السنة الأولى في ثلاثة برامج بكالوريوس (الاقتصاد والإدارة، الاقتصاد والمالية، والإدارة) موزعين على 13 شعبة في جامعة بوككوني بميلانو، وهي من أبرز جامعات الأعمال في أوروبا.
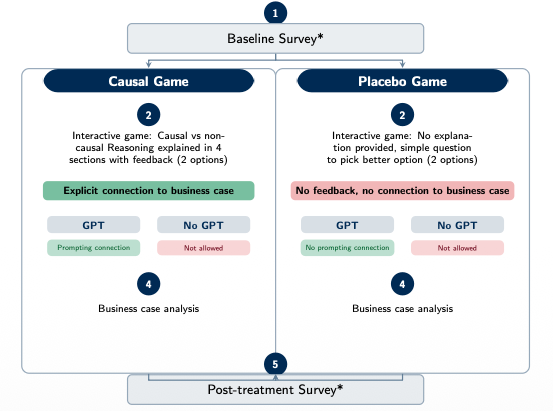
قُسّم الطلاب بالقرعة إلى أربع مجموعات:
- مجموعة التحكم (249 طالباً): أدّت المهمة بمفردها دون أي مساعدة.
- مجموعة التدريب السببي (256 طالباً): تلقت تدريباً قصيراً على «التفكير السببي» — مهارة ربط الأسباب بالنتائج عبر آليات صريحة وتحديد الشروط التي قد تنجح أو تفشل عندها الفكرة. التدريب كان لعبة تعليمية مع أمثلة وأسئلة وتغذية راجعة، ولم يذكر الذكاء الاصطناعي إطلاقاً.
- مجموعة ChatGPT (197 طالباً): حصلت على وصول إلى ChatGPT Edu بنسخة GPT-4o أثناء المهمة.
- المجموعة المدمجة (351 طالباً): حصلت على الاثنين معاً، وقد ضخّم الباحثون حجمها عمداً لقياس التفاعل بينهما بدقة أعلى.
المهمة نفسها كانت واقعية تماماً: 45 دقيقة داخل المحاضرة، بلا إعلان مسبق حتى لا يتغيّر سلوك الحضور، لكتابة توصيات استشارية بحد أقصى 180 كلمة لزيادة وعي الخريجين بمتجر هدايا الجامعة واستخدامهم له — معياران تسويقيان قائمان في أدبيات التسويق. قيّم الأعمال عشرون طالب دراسات عليا درّبهم الباحثون، بثلاثة مصححين لكل حل، وقورنت الحلول منفصلة بتوصيات ثلاثة خبراء تسويق، فضلاً عن تحليل نصي آلي لعدد الأفكار وتنوعها وعلامات التفكير السببي. وأفاد 90.5% من طلاب مجموعات ChatGPT أنهم استخدموه فعلاً.
المصدر: الورقة البحثية الرسمية على موقع OpenAI
النتيجة الأولى: ChatGPT رفع التقييم نحو نقطة كاملة من خمس
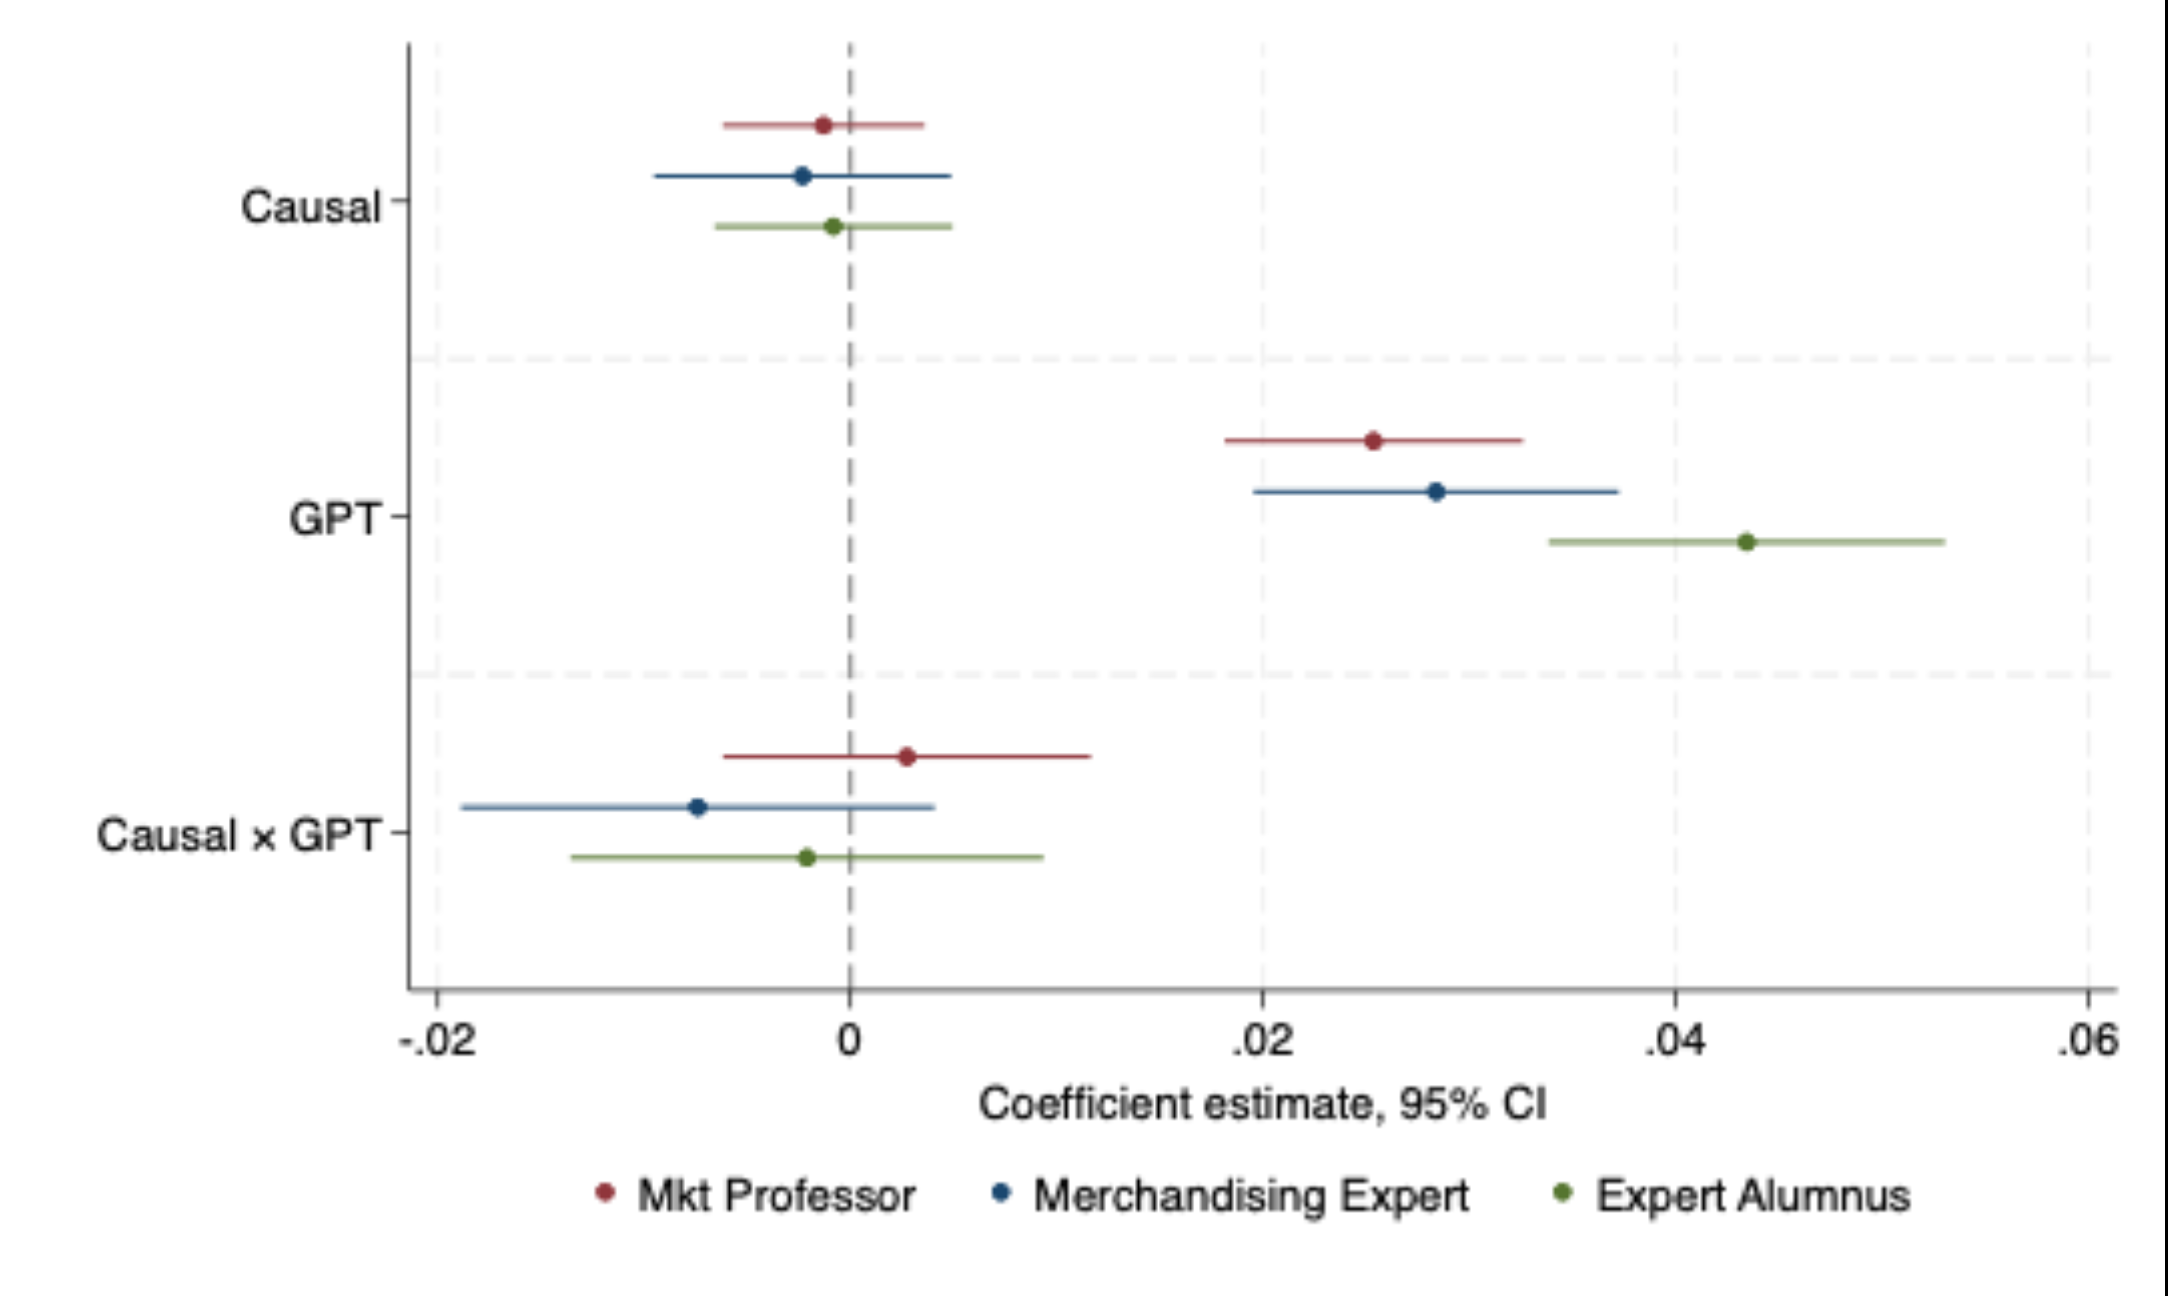
الطلاب الذين استخدموا ChatGPT سجّلوا ارتفاعاً يقارب نقطة كاملة على مقياس تقييم من خمس درجات — وهي قفزة ضخمة بمقاييس البحوث التربوية. أعمالهم احتوت أفكاراً أكثر بوضوح (زيادة تفوق نصف انحراف معياري في عدد الأفكار الجوهرية، أي ما يعادل فكرتين إضافيتين تقريباً في المتوسط)، وحججاً أكثر تماسكاً منطقياً، واقتربت صياغتها من توصيات الخبراء الثلاثة أكثر من أعمال أقرانهم. بعبارة أخرى: الذكاء الاصطناعي ساعد المبتدئين على إنتاج عمل «يبدو أقرب إلى عمل مهني».
المصدر: الورقة البحثية الرسمية على موقع OpenAI
والأهم من ذلك ما وجده الباحثون عند تفكيك هذا الأثر: عند ضبط كل خصائص النص (طول الجمل، التنظيم، عدد الأفكار، تنوعها)، بقيت نحو نصف فائدة ChatGPT قائمة. أي أن الفائدة ليست «تجميلاً لغوياً» فحسب، بل تحسّن حقيقي في مضمون التوصيات نفسها. وهنا نقطة حاسمة يذكرها تقرير OpenAI صراحة: الطلاب لم «يسلّموا» الواجب للنموذج تسليماً أعمى؛ ظل عليهم أن يقرروا ماذا يسألون، وأن يقيّموا الإجابات، وأن يختاروا ما يدخل في الحل النهائي — وهي نفسها مهارات يجب تعلمها، وقد شرحنا قبل ذلك مقارنة عملية بين أدوات الذكاء الاصطناعي الأنسب للطلاب من حيث الاستخدام اليومي.
النتيجة الثانية: التدريب على التفكير السببي غيّر العقل لا الدرجة
هنا مفاجأة البحث الثانية. الطلاب الذين تلقوا تدريب التفكير السببي لم يسجّلوا درجات أعلى — بل جاءت درجاتهم أدنى بفارق طفيف غير معنوي إحصائياً. لكن التحليل النصي كشف أن التدريب غيّر طريقة تفكيرهم جوهرياً:
- ارتفاع تحديد الآليات (لماذا تعمل الفكرة) بنحو 0.5 انحراف معياري.
- ارتفاع استخدام منطق قابلية الدحض (متى قد تفشل الفكرة) بنحو 0.8 انحراف معياري — وهو أكبر تأثير سلوكي في التجربة كلها.
- تنوع أكبر في الأفكار: حلولهم احتوت أفكاراً أكثر اختلافاً عن بعضها، وكانت مجموعة التدريب السببي المجموعة الوحيدة التي أنتجت أفكاراً متمايزة بوضوح عن حلول زملائها في المجموعات الأخرى.
والطلاب الذين جمعوا بين الاثنين — التدريب وChatGPT — جمعوا الفائدتين: درجات عند مستوى مجموعة ChatGPT، مع علامات تفكير سببي وتنوع أفكار عند مستوى مجموعة التدريب. لم يظهر أي تكامل يرفع الدرجات فوق المفرد، لكن لم يلغِ أحدهما الآخر. النتيجة العملية التي خرج بها الباحثون: التفكير السببي مهارة تُثمر حتى في عصر يستخدم فيه الطلاب النماذج اللغوية، ويستحق التدريب عليها.
المفارقة الكبرى: معايير التقييم تكافئ ما يجيده الذكاء الاصطناعي وتعاقب الأصالة
أعمق ما في هذه الورقة ليس أثر ChatGPT بل ما كشفه تحليل معايير التقييم نفسها. عندما فحص الباحثون العلاقة بين خصائص الحلول ودرجاتها وجدوا أن الأفكار الأكثر عدداً والنص الأكثر تماسكاً ترتبط بدرجات أعلى — بينما ترتبط قابلية الدحض والتفصيل الآلي والتمايز عن الأقران بدرجات أدنى. بعبارة صريحة: سلم التصحيح نفسه يكافئ خصيصاً المهارات التي يصعب على الذكاء الاصطناعي تقليدها، ويكافئ الصقل والتنظيم — وهي بالضبط ما يجيده GPT-4o.
من هنا يأتي عنوان التحليل الذي نشرته صحيفة The Decoder المتخصصة يوم 30 أغسطس 2026: «المهارات التي تجلب أعلى الدرجات هي تلك التي يتقن الذكاء الاصطناعي تزييفها أفضل». استنتج مؤلفو الورقة أن على أنظمة التقييم أن تُعاد صياغتها لتكافئ صراحةً الأصالة والاستدلال وتعدد المداخل، لا الاكتفاء بالمخرجات «اللامعة»، وهو ما دعت إليه OpenAI في منشورها بدل الاكتفاء بمنع الأدوات.
مقارنة سريعة: المجموعات الأربع وجهاً لوجه
| المجموعة | العدد | الدرجة على مقياس 5 | عدد الأفكار | التفكير السببي (آليات/دحض) | تنوع الأفكار |
|---|---|---|---|---|---|
| التحكم | 249 | خط الأساس | خط الأساس | خط الأساس | خط الأساس |
| تدريب سببي فقط | 256 | بلا تحسن (أثر سلبي طفيف) | ارتفاع محدود | +0.5 إلى +0.8 انحراف معياري | الأعلى — الأفكار الأكثر تمايزاً |
| ChatGPT فقط | 197 | +نحو نقطة كاملة | +أكثر من 0.5 انحراف معياري | بلا أثر | بلا أثر يذكر |
| تدريب + ChatGPT | 351 | كمجموعة ChatGPT | ارتفاع | ارتفاع مجتمعاً | يبقى ميزة التدريب |
المصدر: الورقة البحثية الرسمية (أغسطس 2026).
ماذا يعني هذا لك كطالب عربي؟ خمس خلاصات عملية
أولاً — استخدم ChatGPT «بوصفه مشرفاً لا كاتباً عنك». أقوى ما في التجربة أن الطلاب الذين استفادوا ظلوا يتخذون القرار: ماذا أسأل، وأي إجابة أقبل، وما يدخل في الحل النهائي. اجعل قاعدتك: لا ينتقل إلى واجبك شيء لم تفهمه وتستطيع الدفاع عنه أمام أستاذك شفهياً.
ثانياً — درّب نفسك على سؤال «لماذا؟» و«متى يفشل؟». التدريب الذي غيّر تفكير الطلاب لم يكن عن الذكاء الاصطناعي أصلاً، بل عن ربط الأسباب بالنتائج. طبّقها اليوم: بعد أي إجابة يحضرها لك النموذج، اكتب في سطرين لماذا تنجح هذه الفكرة ومتى قد تنكسر. هذه العادة هي التي رفعت مؤشرات التفكير السببي 0.8 انحراف معياري في جلسة واحدة.
ثالثاً — لا تتوقع أن «تنجح» الأصالة في كل سلم تصحيح. إن كان أستاذك يصحح بمعايير تقليدية للصقل والتنظيم، فالأصالة المتعمقة قد لا تُكافأ — وقد يكافأها سوق العمل لاحقاً. افهم معايير التقييم أولاً ثم قرر أين تضع طاقتك.
رابعاً — الوصول مجاني جزئياً، والنسخة الأقوى صارت في المتناول. التجربة استخدمت ChatGPT Edu بنسخة GPT-4o، وهي متاحة اليوم ضمن خطة ChatGPT Plus للطلاب بخصم وبديل اقتصادي مشترك شرحناها بالتفصيل، مع مقارنة بينها وبين بدائل مثل اشتراك Perplexity Pro للطلاب. وإن كنت تستخدم أدوات ذكاء اصطناعي في البحث العلمي فراجع دليلنا لأفضل أدوات الذكاء الاصطناعي للأبحاث الأكاديمية.
خامساً — تابع الأدلة لا الهلع. الجدل التربوي حول الذكاء الاصطناعي مليء بالانفعال؛ هذه التجربة — مع كل حدودها — نموذج لكيفية القراءة الهادئة: انظر التصميم، انظر الأرقام، انظر حدود الاستنتاج. ولمتابعة كيف تُدمج الأدوات فعلياً في التعليم، اقرأ أيضاً ميزات Khanmigo الجديدة بدعم Google Gemini للفصول الدراسية، وإن أردت بناء أدواتك الخاصة فوق نماذج مفتوحة فتصفح قائمة أدوات الذكاء الاصطناعي في Truescho. ولسياق أوسع عن توجهات OpenAI البحثية والفكرية هذا الشهر، راجع شرحنا لـمدونة Intelligence Age وفريق Strategic Futures.
الأدلة المعاكسة: ما لا تخبرك به هذه الدراسة
أمانة العرض تقتضي عرض الصورة الأخرى التي جمعتها The Decoder في تحليلها:
- تجربة صينية ممتدة 30 شهراً على أكثر من 26 ألف طالب: تحسّن أداء الواجبات مع استخدام الذكاء الاصطناعي، لكن درجات الاختبارات تراجعت، وفي اختبارات القبول اللاحقة جاءت نتائج المستخدمين أدنى بنسبة 18–24% على المدى الطويل. الاستثناء اللافت: الطلاب الذين أبقوا وقت مذاكرتهم كما هو دون تقليص لم يعانوا التراجع نفسه.
- تحليل أكثر من 500 ألف درجة جامعية أمريكية: أعلى ارتفاع في الدرجات حدث في المقررات الكثيفة الكتابة والبرمجة — نمط يوحي بانتشار تسليم أعمال بمساعدة الذكاء الاصطناعي.
- تجارب محكومة بإزالة الأداة: بعد سحب الذكاء الاصطناعي، تفوق من لم يستخدمه على من استخدمه، وكان التراجع الأشد بين من استخدموه للحصول على إجابات مباشرة — حتى عشر دقائق من الاستخدام «الآلي» أثّرت قياسياً على حل المشكلات.
القاسم المشترك بين كل هذه الأدلة: الخطر ليس في الأداة بل في أن تحل محل تفكيرك بدل أن تسنده.
حدود الدراسة التي يجب التصريح بها
- لا اختبار لاحق بدون أداة: لم يقيس التصميم أداء الطلاب بعد إزالة ChatGPT، لذا لا يمكن التمييز بين «تعلم يُكتسب ويُحفظ» و«مخرجات استُعيرت دون اكتساب». المؤلفون أنفسهم كتبوا حرفياً إنهم لا يستطيعون الجواب.
- نطاق ضيق: جامعة واحدة، سنة أولى، مهمة تسويقية واحدة بـ180 كلمة، وعشوائية على مستوى الشعبة لا الفرد.
- تضارب مصالح معلن: OpenAI موفرة التقنية المدروسة وشريك في البحث، وعدد من المؤلفين موظفون لديها أو تعاقدت معهم. هذا لا يبطل المنهجية (مسجلة مسبقاً ومصححوها لا يعرفون المجموعات)، لكنه سبب إضافي للانتظار حتى تتكرر النتيجة عند باحثين مستقلين.
ماذا على الجامعات أن تفعل؟
الورقة توجه رسالة مزدوجة للمؤسسات التعليمية: منع الأدوات لم يعد خياراً واقعياً ولا مفيداً، والأهم إعادة تصميم التقييم بحيث يكافئ ما لا يستطيع النموذج تقليده: الأصالة، الاستدلال السببي، تعدد المداخل، والدفاع الشفهي عن الفكرة. كما ترى في التجربة أن مهارة قابلة للتدريب في جلسة قصيرة (التفكير السببي) أنتجت أثراً سلوكياً أكبر من أي أداة — رسالة عملية للمناهج: علّم السؤال «لماذا» قبل تعليم أي أداة.
وليست الرسالة موجهة للجامعات وحدها. المدرسة الثانوية والأسرة يمكنهما تطبيق الخلاصة نفسها بمقاييس أصغر: اجعل الطالب يشرح سبب اختياره لكل فكرة يستعيرها من أي أداة، واسأله «متى قد تنجح هذه الفكرة ومتى تنكسر؟» قبل قبول العمل. هذه الأسئلة الثلاثة — لماذا تعمل؟ متى تفشل؟ ما البديل؟ — هي نسخة منزلية مبسطة من تدريب التفكير السببي الذي رفع مؤشرات عمق التفكير في التجربة، ولا تحتاج أي تقنية أو تكلفة: تحتاج فقط معلماً أو والداً يطرحها بانتظام ويصبر على الإجابة.
الأسئلة الشائعة
هل أثبتت الدراسة أن ChatGPT يضر التفكير الناقد؟
لا. لم تجد الدراسة أي دليل على ضرر مباشر خلال المهمة، لكنها لم تقس الأثر طويل المدى أيضاً. ما أثبتته: ChatGPT حسّن جودة المخرجات، والتدريب على التفكير السببي حسّن عمق التفكير وتنوع الأفكار، وكل منهما يعمل في اتجاه مختلف. الأدلة طويلة المدى من دراسات أخرى تشير إلى أن الضرر يظهر عندما تحل الأداة محل المذاكرة لا عندما تسندها.
لماذا لم يرفع التدريب على التفكير الناقد الدرجات؟
لأن سلم التقييم استخدم معيارين قياسيين في التسويق (رفع الوعي ورفع الاستخدام) يكافئان الحلول المنظمة الواضحة، بينما أثر التدريب ظهر في أبعاد لا يلتقطها السلم: قابلية الدحض، الآليات، وتنوع الأفكار. الباحثون أنفسهم لاحظوا أن قابلية الدحض والآليات ارتبطت سلباً بالدرجة — أي أن المشكلة في أداة القياس لا في المهارة.
ما نموذج ChatGPT المستخدم في التجربة وهل يتوفر للطلاب؟
استخدمت التجربة ChatGPT Edu بنسخة GPT-4o عبر واجهة محددة أثناء المهمة. GPT-4o متاح اليوم ضمن الخطة المجانية من ChatGPT بحدود استخدام، وبشكل أوسع ضمن خطة Plus التي شرحنا طرق الاشتراك الاقتصادية فيها في دليل خصم الطلاب.
هل تنطبق نتائج جامعة إيطالية على الطالب العربي؟
آليات الأساس — أن النموذج يرفع جودة الصياغة والمضمون للمبتدئين، وأن التدريب السببي يرفع عمق التفكير — عامة وليست مرتبطة بجنسية. لكن التعميم يحتاط: المهمة كانت تسويقية بالإنجليزية/الإيطالية في سياق أوروبي، والمعايير الثقافية للتقييم قد تختلف، والدراسة نفسها من جامعة واحدة.
ما الفرق بين هذه الدراسة ودراسات «ChatGPT يضعف العقل» المنتشرة؟
معظم ما ينتشر إما مسوح استبيانية غير مسيطر عليها أو تجارب قصيرة جداً على مهام مغلقة. هذه تجربة عشوائية مسجلة مسبقاً بمجموعة تحكم حقيقية على مهمة واقعية بعشرات المصححين البشريين ومقارنة بخبراء — أي أعلى بكثير في سلّم الأدلة، مع حدودها المذكورة أعلاه.
هل يجب على الجامعات العربية منع ChatGPT بعد هذه النتائج؟
الدراسة لا تدعم المنع؛ فهي لم تجد ضرراً مباشراً، وأظهرت أن الاستخدام النشط (سؤال، تقييم، اختيار) مع تدريب سببي يعطي أفضل مزيج من جودة المخرجات وعمق التفكير. التوصية العملية الأقرب للدليل: السماح مع إعادة تصميم التقييم ليكافئ الأصالة والاستدلال، وتدريب الطلاب على الاستخدام النشط.
المصادر
- OpenAI — Better answers, broader thinking: What students gain from ChatGPT and critical-thinking training (27 أغسطس 2026)
- الورقة البحثية الكاملة: Training novices to think, or giving them LLMs? Evidence from an RCT (PDF رسمي)
- The Decoder — The skills that earn top grades are the ones AI can fake best (30 أغسطس 2026)
- TechCrunch — تغطيات مستمرة لأبحاث OpenAI التربوية
ابدأ رحلتك مع Truescho: إن كنت طالباً تبحث عن منحة تناسب تخصصك، استكشف فرص التمويل الكامل المتاحة الآن، أو جرّب خدمة التقديم نيابة عنك لتوفير وقتك لما يهم فعلاً: تعلّم يبقى.