Gemini 3.8 Live من جوجل: محادثة صوتية لحظية بـ97 لغة بينها العربية
آخر تحديث: سبتمبر 2026
أعلنت جوجل يوم 15 سبتمبر 2026 عن نموذجين جديدين للحوار الصوتي هما Gemini 3.8 Live وGemini 3.8 Live Extended Thinking، وتصفهما بأنهما أكثر نماذج الحوار الحي تقدماً لديها حتى اليوم. النموذجان يتحدثان ويفكران في الوقت نفسه، ينفذان المهام في الخلفية دون أن يقطعا الحديث، وينتقلان تلقائياً بين 97 لغة مدعومة — والعربية من بينها وفق توثيق Live API الرسمي. الإعلان متاح منذ اليوم نفسه في تطبيق Gemini وأدوات Google Workspace ومحرك البحث وواجهة المطورين.
ما الذي أعلنته جوجل بالضبط؟
الإعلان صدر في الساعة 17:00 بتوقيت غرينتش من فريق Gemini Audio على المدونة الرسمية، بتوقيع توم أويانغ (كبير المهندسين) وماليني جاغاناثان. والمحتوى الجوهري هو نموذجان لكل منهما وظيفة مختلفة:
- Gemini 3.8 Live: النموذج المخصص للتوسع وكفاءة التكلفة. يجمع بين ذكاء المحادثة وحوار طبيعي سلس مع فهم بصري لما يظهر أمام الكاميرا أو على الشاشة، وهو الخيار الافتراضي لتجارب المساعدات الصوتية منخفضة التأخير.
- Gemini 3.8 Live Extended Thinking: النموذج الأثقل، مبني للمهام عالية التعقيد التي تحتاج تفكيراً متعدد الخطوات. الفرق الجوهري أنه «يفكر ويتحدث في آن واحد»: يقرأ طلبك بجملة مثل «دعني أتحقق من ذلك…»، ثم يسرد تقدمه خطوة بخطوة وهو يعمل، دون صمت مطول كما في النماذج الصوتية السابقة.
ما يجعل هذا الإعلان مهماً ليس الأرقام وحدها، بل أنه يعيد تعريف ما نتوقعه من مساعد صوتي: بدلاً من مساعد يجيب ثم يتوقف، لدينا طرف محادثة يدير مهاماً حقيقية — حجوزات، بحث، أدوات، استدعاءات API — بينما يستمر الحديث بشكل طبيعي تماماً.
نتائج تفتح فجوة عن المنافسين
عند إطلاق نموذج صوتي جديد، السؤال الأول دائماً: هل يفهم فعلاً أم يبدو ذكياً فقط؟ جوجل أجابت بحزمة أرقام من جهات تقييم مستقلة:
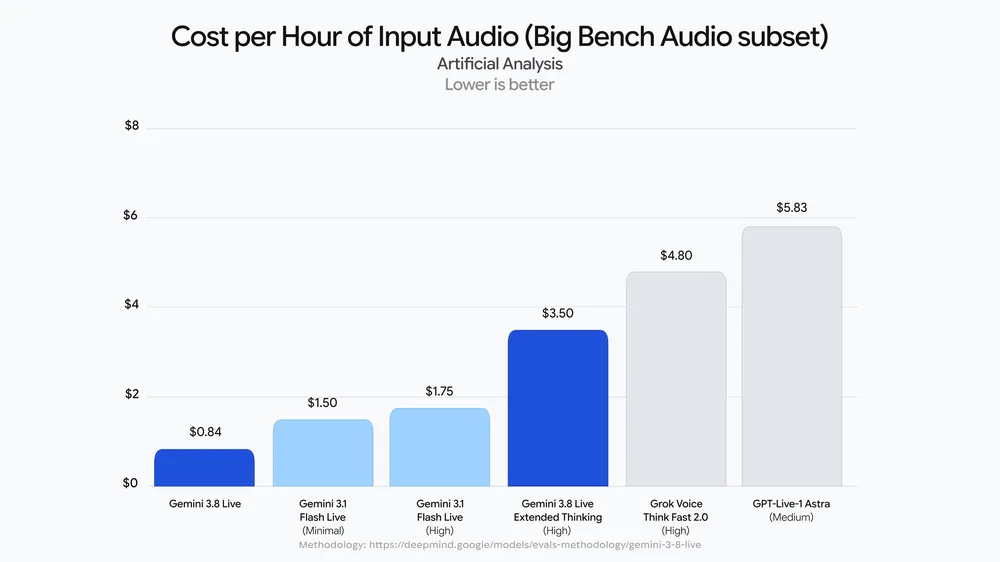
المصدر: مدونة جوجل الرسمية — إعلان Gemini 3.8 Live
- المركز الأول في مؤشر Artificial Analysis لجودة الكلام إلى الكلام بنقطة 82.6 لنموذج Extended Thinking — وهو المرجع الذي تتابع به صناعة النماذج الفجوات بين المختبرات.
- 68.6% على معيار τ-Voice و35.1% على معيار τ-Voice-banking من شركة Sierra لاستكمال المهام الوكيلية بالصوت، وهي أرقام تقيس القدرة على إنجاز مهمة كاملة عبر الحوار لا مجرد الدردشة.
- 97.7% على Big Bench Audio، وهي أعلى درجات الفهم الصوتي المعلنة حتى الآن لنماذج الحوار الحي.
- النموذج الأساسي 3.8 Live حقق المركز الثاني في Speech Agent Arena، منصة المباريات المفتوحة التي يصوّت فيها المستخدمون على أفضل مساعد صوتي.
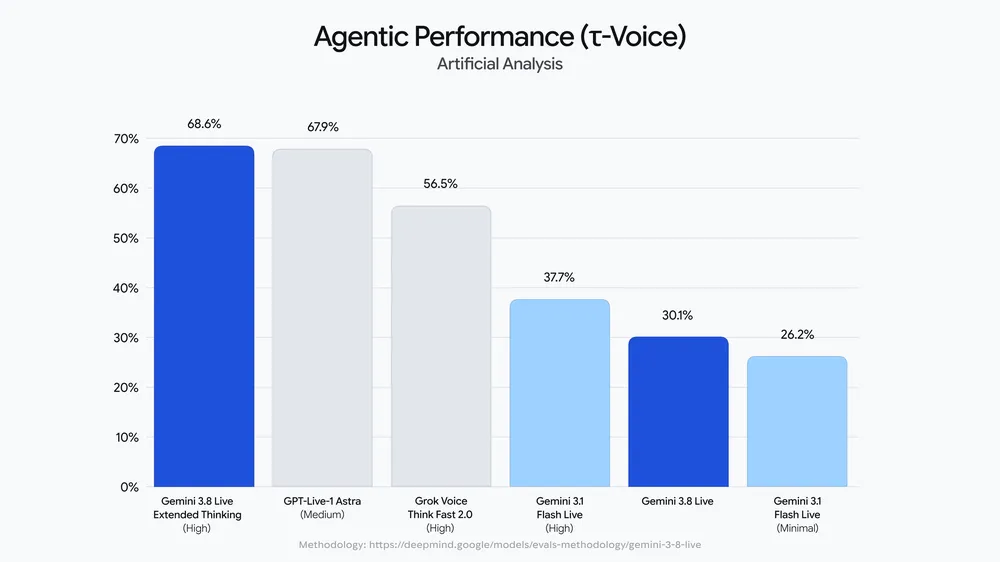
المصدر: مدونة جوجل الرسمية — إعلان Gemini 3.8 Live
على منصة ServiceNow EVA-Bench لتقييم وكلاء الصوت في سير عمل حقيقي، تقول جوجل إن نموذجيها يدفعان «حدود باريتو» إلى الأمام — أي التوازن الأفضل بين الدقة وجودة المحادثة معاً بدل التضحية بأحدهما.
أسئلة يبحث عنها الجميع الآن
هل يدعم Gemini 3.8 Live اللغة العربية؟
نعم. قائمة لغات Live API الرسمية في توثيق مطوري جوجل تتضمن 97 لغة بينها العربية برمزها (ar)، وينتقل النموذج بينها تلقائياً وسط المحادثة إذا بدأت بالعربية ثم انتقلت للإنجليزية. الإعلان نفسه يذكر أن النموذج «يكتشف اللغات الـ97 المدعومة وينتقل بينها أثناء الحديث» دون تدخل منك. جودة اللهجات العربية المختلفة تبقى محل اختبار عملي من المستخدمين.
كم سعر Gemini 3.8 Live في واجهة المطورين؟
للمطورين عبر Gemini API: إدخال الصوت 3 دولارات لكل مليون توكن أو ما يعادل 0.005 دولار للدقيقة الواحدة، وإخراج الصوت 12 دولاراً لكل مليون توكن (نحو 0.018 دولار للدقيقة). النص المُدخل 0.75 دولار والمُخرج 4.50 دولار لكل مليون توكن، مع فئة استخدام مجانية متاحة للتجربة.
ما الفرق بين Gemini 3.8 Live وExtended Thinking؟
الأول مبني للتوسع والتكلفة المنخفضة والحوار السريع اليومي، والثاني للتفكير العميق متعدد الخطوات والمهام المعقدة مع سرد حي للتقدم. الأول يكفي لمساعد خدمة عملاء أو تطبيق حواري خفيف، والثاني للمهام التي تحتاج تخطيطاً وتنفيذاً متسلسلاً دون انقطاع المحادثة.
هل Gemini 3.8 Live مجاني؟
في تطبيق Gemini تتوفر تجربة النماذج ضمن الفئة المجانية والمدفعة، وفي الـ API توجد فئة مجانية بحدود استخدام أقل تناسب التجريب والبناء الأولي، ثم تنتقل للدفع حسب الاستهلاك. لا يوجد إعلان عن اشتراك منفصل خاص بالنموذجين.
أين أجرب Gemini 3.8 Live اليوم؟
أربع واجهات متاحة منذ يوم الإعلان: تطبيق Gemini على الهاتف، أدوات Workspace مثل Docs Live وGmail Live وKeep Live، قسم Search Live في نتائج البحث لحل المشكلات خطوة بخطوة، وGemini API للمطورين عبر Live API مباشرة.
ماذا يعني هذا للمستخدم العربي؟
هنا تكمن القصة الحقيقية لهذا الإطلاق بالنسبة لنا. محاولات استخدام المساعدات الصوتية بالعربية ظلت لسنوات تجربة محبطة: إما لغة غير مدعومة، أو فهم ضعيف، أو ردود مكتوبة تُقرأ بصوت آلي. توفر نموذج حوار حي ينتقل بين العربية والإنجليزية تلقائياً وسط الجملة الواحدة يخدم حالة استخدام يومية واضحة: الطالب الخليجي الذي يذاكر بالإنجليزية ويسأل بالعربية، والموظف الذي يلخص بريده بالإنجليزية ثم يناقش النتيجة بالعربية.
وإذا كنت تتابع تغطيتنا السابقة لميزة Gemini Live داخل Gmail وDocs وKeep، فهذا الإعلان هو الطبقة التي تدير تلك التجربة: نماذج أذكى وأسرع لكل أوامر التحكم الصوتي نفسها. ولمن يقارن خيارات الاشتراك، يتوفر اشتراك Gemini Advanced بشارك عربي ميسور عبر متجر Truescho بديلاً عن السعر العالمي.
والمفارقة التسويقية تستحق التوقف: هذا الإعلان يأتي بعد يومين فقط من إعلان OpenAI نموذجها الصوتي GPT-Live-1 للمطورين، وهو ما شرحناه في مقالنا عن نموذج GPT-Live-1 الصوتي بسعر 0.05 دولار للدقيقة. سباق المساعدات الصوتية انتقل من مرحلة «من يجيب أسرع» إلى «من ينجز المهمة كاملة أثناء الحديث».
مقارنة سريعة: أين يقف أمام البدائل؟
| المعيار | Gemini 3.8 Live | GPT-Live-1 (OpenAI) | Gemini 3.8 Flash (نصي) |
|---|---|---|---|
| النوع | حوار حي صوتي + بصري | حوار حي صوتي للـ API | نموذج نصي للتفكير والبرمجة |
| اللغات | 97 لغة مع تبديل تلقائي | أساساً الإنجليزية عند الإطلاق | متعدد اللغات نصياً |
| سعر دخل الصوت | 0.005 دولار/دقيقة | ~0.05 دولار/دقيقة (نموذج صوتي كامل) | لا ينطبق |
| تنفيذ مهام بالخلفية | نعم أثناء الحوار | محدود بالتصميم الحالي | نصي فقط |
| الأنسب لـ | مساعدات صوتية إنتاجية عربية | تطبيقات صوتية إنجليزية متقدمة | برمجة وبحث نصي |
نموذج 3.8 Flash النصي غطيناه بالتفصيل في مقال إطلاق Gemini 3.8 Flash لأقوى تفكير وبرمجة — النموذجان الجديدان لا يستبدلانه بل يضيفان طبقة الصوت الحي فوقه.
للمطورين: الأرقام التي تهم محفظتك
- نافذة السياق: إدخال حتى 131,072 توكن وإخراج حتى 65,536 توكن في الجلسة الحية.
- المدخلات: نص وصور وصوت وفيديو. المخرجات: نص وصوت.
- استدعاء الدوال غير المتزامن صار الافتراضي: النموذج يستلم طلبك، يشغلك بالحديث، ويعيد النتيجة عندما تكتمل الأداة في الخلفية — مع خيارات جدولة (SILENT / WHEN_IDLE / INTERRUPTED).
- الصوت الاستباقي مفعّل دائماً: لا يمكن إطفاؤه في هذا الإصدار، والنموذج يقاطع أو يتابع بحسب سياق الحوار.
- منصات البناء الجاهزة أعلنت دعمها من اليوم: LangChain وLiveKit وPipecat وVercel وAgora وغيرها، ما يعني أن بإمكان أي فريق عربي صغير بناء مساعد صوتي إنتاجي دون بنية تحتية صوتية خاصة.
للقارئ المهتم ببناء وكلاء أذكى داخل بيئات عمل كاملة، مقالنا عن OpenAI Agents API وصناديق العزل المستضافة يكمل الصورة من الجهة المقابلة.
حدود يجب معرفتها قبل الانبهار
الأمانة المهنية تقتضي تسجيل ما لم تؤكده جوجل بعد. النموذج لا يدعم حالياً المخرجات المنظمة (Structured Outputs) ولا التخزين المؤقت للسياق (Caching) ولا تنفيذ الكود داخل الجلسة، وهي ميزات موجودة في النماذج النصية — فمن يبني نظاماً هجيناً سيحتاج نموذجاً نصياً بجانبه. الرسوم «لكل دقيقة» في الصوت تعتمد على استهلاك التوكنات الفعلي، ما يجعل تقدير التكلفة النهائية لتطبيق حي أمراً يحتاج قياساً عملياً لا حساباً نظرياً. وأخيراً، ادعاء «97 لغة» لا يعني جودة متطابقة بينها؛ اللهجات العربية الخليجية والمغاربية تحتاج اختباراً ميدانياً قبل الاعتماد الإنتاجي عليها.
المصادر
- مدونة جوجل الرسمية — Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking — الإعلان الأولي بكل الأرقام
- توثيق Gemini API — صفحة نموذج gemini-3.8-live — حدود التوكنات والقدرات
- توثيق Live API وقائمة اللغات الـ97 — تأكيد دعم العربية (ar)
- صفحة أسعار Gemini API الرسمية — تسعير الصوت والنص والفئة المجانية
- SiliconANGLE — Google's new speech model supports real-time reasoning — تغطية مستقلة
وإذا كنت ممن يريدون تجربة قوة Gemini كاملة باشتراك ميسور، ألقِ نظرة على عروض المتجر الرقمي في Truescho — وأخبرنا في التعليقات: هل ستستبدل مساعدك الصوتي الحالي بنموذج يفكر ويتحدث معاً؟