أنثروبيك: كلود يقود 26% من أبحاثها — الذكاء الاصطناعي يبني نفسه
آخر تحديث: سبتمبر 2026
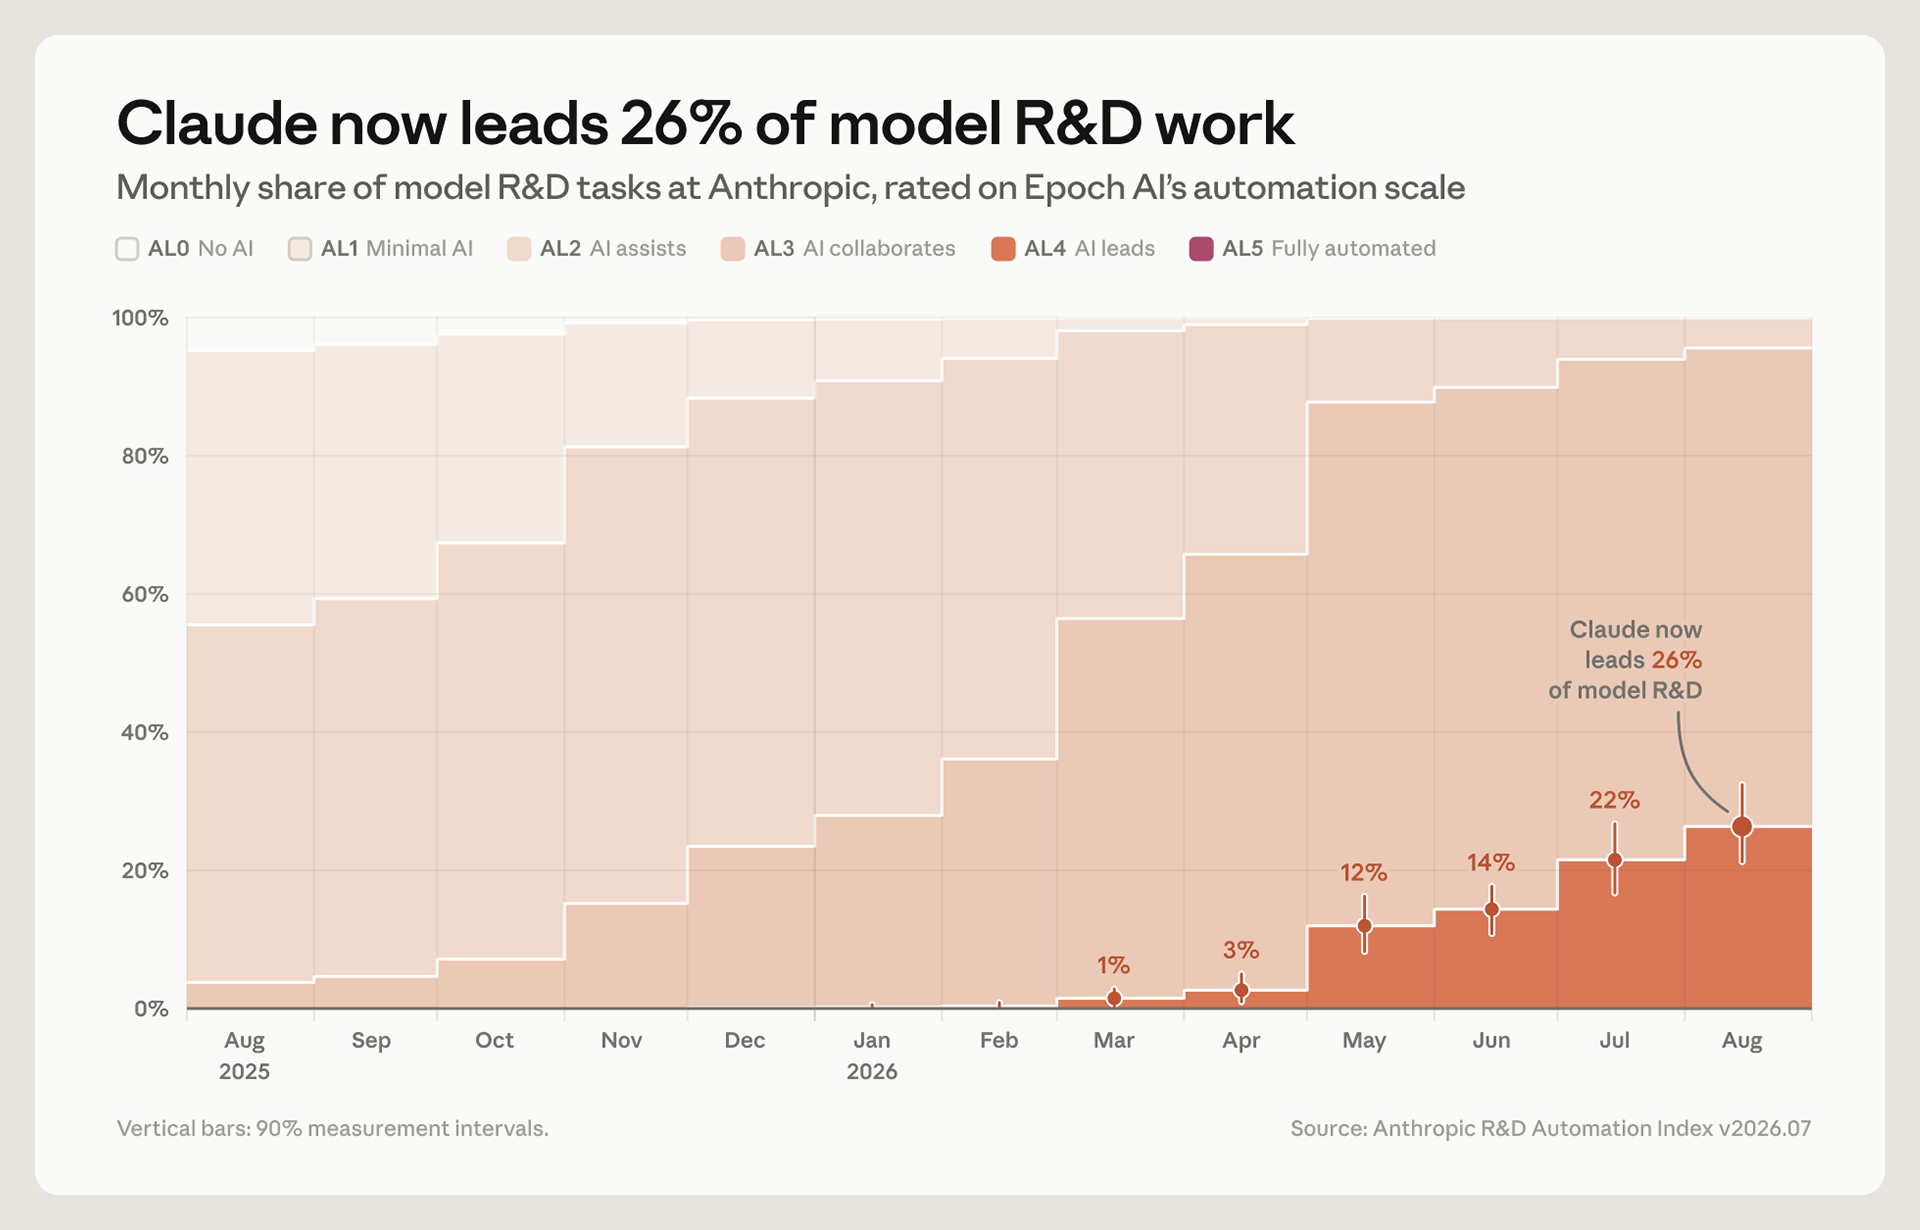
أعلنت أنثروبيك مساء 17 سبتمبر 2026 أن نموذجها كلود أصبح «يقود» 26% من عملها البحثي وتطويري في مجال الذكاء الاصطناعي حتى أغسطس 2026، صعوداً من أقل من 1% في فبراير الماضي، وأن أكثر من 90% من هذا العمل يجري الآن بمشاركة الذكاء الاصطناعي كمساعد متعاون أو أعلى. الرقم صادر عن منشور رسمي على منصة أنثروبيك إنستيتيوت بعنوان «قياسات لفهم وتيرة تطور الذكاء الاصطناعي داخل المختبرات المتقدمة»، وهو أول قياس منشور بهذا التفصيل من داخل مختبر متقدم.
المصدر: Anthropic
ماذا حدث بالضبط؟
لم يعد الحديث عن «الذكاء الاصطناعي يبني الذكاء الاصطناعي» سيناريو مستقبلياً. أنثروبيك نشرت ثلاث مجموعات من القياسات الداخلية توثّق كيف صار كلود شريكاً فعلياً في بناء الجيل التالي من النماذج، لا مجرد أداة كتابة أكواد. المنشور من إعداد الباحثتين مارينا فافارو وفيلي رايت بتوجيه بحثي من جاك كلارك، أحد مؤسسي الشركة، وغطّته خلال ساعات وكالات عالمية كبرى من رويترز وبلومبرغ إلى أسوشيتد برس، بعناوين مثل «كلود يساعد في بناء النسخة التالية من نفسه».
النقطة الأدق التي أفلتت من بعض التغطيات السريعة: أنثروبيك لم تقل إن كلود يعمل باستقلال تام. التصنيف المستخدم هو مقياس Epoch AI لمستويات الأتمتة، وكلود وصل إلى المستوى الرابع (AL4) حيث «يقود» العمل في ربع المهام، بينما لا يوجد أي عمل مقيس بلغ فيه المستوى الخامس (AL5) أي الاستقلال الكامل. الفارق بين الرقمين هو الفارق بين شراكة حقيقية ووكالة ذاتية، وهذا الفارق يهم كل من يتابع مستقبل وظائف البحث والبرمجة.
الأرقام بالتفصيل: ثلاث قياسات لا رقم واحد
| القياس | القيمة المعلنة | ماذا يعني عملياً |
|---|---|---|
| حصة كلود «القائدة» من أبحاث أنثروبيك | 26% (مستوى AL4) | كلود يقود ربع العمل البحثي التطويري، بعد أن كانت الحصة أقل من 1% في فبراير 2026 |
| العمل بمشاركة الذكاء الاصطناعي أو أعلى | أكثر من 90% | الغالبية الساحقة من المهام البحثية صارت تتم بمساعدة النماذج |
| الوكلاء المتزامنة داخلياً | نحو 30,000 وكيل | على أكثر المنصات استخداماً داخل الشركة |
| قرارات حُجبت من أصل مليار+ | 0.002% (1 من كل 47,000) | أنظمة رقابة افتراضية تعترض الإجراءات الخطرة قبل تنفيذها |
| حوسبة البحث الموجهة للسلامة | نحو 6% | مقابل نحو 12% لحوسبة بحثٍ يقوده الذكاء الاصطناعي نفسه (أسبوع 13–20 يوليو) |
المصدر: منشور أنثروبيك إنستيتيوت الرسمي
رقابة الوكلاء تستحق وقفة: أنثروبيك كشفت أن مراقبين افتراضيين يفحصون 100% من إجراءات الوكلاء قبل التنفيذ «عادة خلال ثوانٍ»، وأن مراجعة لاحقة تمسح كل المحادثات بعد وقوعها، فتميّز نحو 100,000 محادثة أسبوعياً وتُحيل نحو 50 حالة فقط إلى بشر للمراجعة خلال أسبوع. أي أن فكرة «مختبر يطلق وكلاء بلا رقيب» لم تعد وصفاً دقيقاً لما يحدث داخلياً على الأقل عند هذا المختبر.
كيف قاست أنثروبيك ذلك؟ منهجية بشفافية غير معتادة
الشركة لم تكتفِ بإطلاق نسبة مئوية، بل نشرت طريقة الوصول إليها: عيّنة أسبوعية من 20% من الموظفين خلال يوليو 2026 عبر سجلات Slack والمستندات الداخلية، أنتجت نحو 15,000 مهمة وُزّعت على شجرة مهام مجمّدة من 542 عقدة، ثم قيّمها قاضٍ نسخة من كلود نفسه. وفي خطوة تُحسب لها، نشرت أرقام موثوقية القاضي: توافق تام بين النموذج والإنسان بنسبة 59%، وهو أعلى من توافق البشر مع بعضهم البعض في نفس التقييم (35%)، مع تقارب ضمن مستوى واحد في 97% من الحالات.
نفس الروح التحفظة ظهرت في قياس الحوسبة: صنّف الذكاء الاصطناعي نفسه أحمال العمل على عيّنة من نحو 14% من 10,000 تشغيلة، واعتمدت الشركة التعريف الأوسع للسلامة عند الاشتباه، بحيث تُحسب الأحمال مزدوجة الغرض (سلامة وقدرات معاً) كبحثٍ وتطوير لا كسلامة، وهو ما يجعل نسبة الـ6% الموجهة للسلامة تقديراً متحفظاً لا منفخاً.
ماذا يعني هذا لك؟
إذا كنت مبرمجاً أو باحثاً في السعودية أو الإمارات أو مصر أو أي بلد عربي، فالرسالة المزدوجة واضحة. أولاً: سرعة تطور النماذج مرشحة للازدياد لأن المختبرات صارت تستخدم منتجاتها لتسريع بناء منتجاتها، والمستفيد النهائي هو مستخدم الأدوات في المنطقة، إذ تصل التحسينات إلى كلود وClaude Code وأدوات الكتابة والتحليل أسرع من أي دورة تطوير سابقة. ثانياً: المهام المتوسطة في البحث والبرمجة ستتقلص تدريجياً، والقيمة تنتقل إلى من يجيد توجيه هذه الأنظمة ومراجعة مخرجاتها، وهي مهارة قابلة للتعلم اليوم بأدوات متاحة فعلياً في الخليج عبر الاشتراكات السحابية العادية.
الخلفية السياقية مهمة أيضاً: هذا المنشور يأتي بعد أيام من مقالة الرئيس التنفيذي داريو أمودي «علينا أن نضبط إيقاع الحدود» التي ناقشناها بالتفصيل في تغطيتنا لاتفاق كبار المختبرات على إبطاء السباق، ويضع أرقاماً خلف الكلمات: نعم التسارع حقيقي، وهذه أول مرة يكشف مختبر حجم الأتمتة الداخلية بهذا التفصيل.
مقارنة سريعة: كيف يتعامل كل مختبر مع أتمتة أبحاثه؟
| الجهة | ما نُشر رسمياً | مستوى التفصيل |
|---|---|---|
| أنثروبيك | كلود يقود 26% من أبحاثها، 90%+ بمشاركة AI، منشور منهجية كامل | الأعلى حتى الآن: أرقام وحدود ومنهجية |
| OpenAI | أعلنت سابقاً برنامج باحث آلي داخلي (RSI) وتقارير حوادث سوء التوجه | إعلانات متفرقة بلا مؤشر موحد منشور |
| غوغل ديب مايند | تركّز على خطاب السلامة والحوكمة عبر مبادراتها الجديدة دون نشر نسب أتمتة داخلية | نوعي لا كمي |
المقارنة تكشف اتجاهاً جديداً: الشفافية صارت ورقة تنافسية. أول مختبر ينشر أرقاماً داخلية قابلة للنقاش يكسب مصداقية أمام المشرّعين والمستخدمين، وهذا بالضبط ما يفسر الاهتمام العالمي الواسع بالمنشور خلال ساعات.
حدود الدراسة: اقرأ الأرقام بعين ناقدة
المنشور مبادرة جيدة لكنها ليست دراسة محكّمة: العيّنة من شركة واحدة تقيس نفسها، والقاضي نسخة من كلود وهو الطرف المستفيد من النتيجة الإيجابية، ومستوى الاستقلال الكامل AL5 لم يتحقق في أي عمل، أي أن «الذكاء الاصطناعي يبني نفسه» تبقى مشاركة بشرية جوهرية فيها. كما أن الأرقام خاصة بأنثروبيك ولا يمكن تعميمها على الصناعة، والقياس توقف عند أغسطس 2026، أي أن أي قفزة لاحقة لم تُلتقط بعد.
هل معنى هذا أن كلود أصبح باحثاً مستقلاً؟
لا. مستوى AL4 يعني أن كلود يقود العمل مع إشراف بشري، ولم يصل أي عمل مقيس إلى AL5 أي الاستقلال الكامل. البشر ما زالوا يضعون الأهداف ويراجعون القرارات المحجوبة خلال أسبوع كحد أقصى.
ما علاقة الرقم بمقالة داريو أمودي عن إبطاء السباق؟
المنشور يشير مباشرة إلى مقالة أمودي «We Must Pace the Frontier» ويقول إن هذه الأرقام هي الأساس الذي يُبنى عليه أي نقاش جاد حول ضبط إيقاع التطوير، لأن القرار بلا قياس يبقى جدلاً نظرياً.
هل تتحكم أنثروبيك فعلاً في عشرات آلاف الوكلاء؟
وفق أرقامها: مراقبة افتراضية قبلية تغطي 100% من الإجراءات خلال ثوانٍ، ومراجعة لاحقة تمسح كل المحادثات، وحجب 1 من كل 47,000 قرار. الشفافية في النشر لا تلغي الحاجة إلى تحقق خارجي مستقل.
ما أثر ذلك على فرص العمل البرمجية في المنطقة؟
المهام الروتينية المتوسطة ستتقلص أسرع، بينما ترتفع قيمة من يجيد إدارة فرق الوكلاء ومراجعة مخرجاتها. الاستثمار في مهارات التوجيه والمراجعة اليوم هو التحوط العملي.
متى تصل هذه القدرات إلى المستخدم العادي؟
قدرات كلود المتاحة للجمهور تتحسن مع كل دورة تطوير تسارعت بهذه الأتمتة، لكن الرقم 26% يخص الأبحاث الداخلية للشركة وليس منتجاً يمكن شراؤه اليوم.
المتابعة العملية الآن تتركز على ثلاثة أمور: هل يتبع مختبرات أخرى نهج النشر الرقمي نفسه، وهل تتكرر القياسات فصلياً فتتحول من مبادرة إلى معيار صناعي، وهل تنعكس الأتمتة الداخلية على أسعار وتوقيت الإصدارات القادمة. نحن في تروسكو سنواصل تتبع هذه الملفات ضمن تغطيتنا المستمرة لأخبار الذكاء الاصطناعي، وإن كنت طالباً أو مهنياً يريد الانتقال من متابعة الأخبار إلى مهارة فعلية، ابدأ من دورات الذكاء الاصطناعي المجمّعة في تروسكو.
المصادر
- Anthropic — Measurements for understanding the pace of AI development — المنشور الرسمي بكل الأرقام والمنهجية
- تغطية رويترز: كلود يقود ربع عمل بناء النماذج التالية — أول تأكيد وكالات عالمية (17 سبتمبر)
- أسوشيتد برس: كلود يساعد في بناء النسخة التالية من نفسه — التغطية الأمريكية الرئيسية (18 سبتمبر)
- تغطيتنا: كبار المختبرات تتفق على إبطاء السباق — الخلفية الكاملة لمقالة أمودي
- تغطيتنا: إطار OpenAI للتعامل مع سوء توجه النماذج — كيف تتعامل المختبرات مع سلوك النماذج