
تحليل استبيان بالذكاء الاصطناعي: 5 خطوات آمنة ومتى تحتاج SPSS
آخر تحديث: نوفمبر 2026
الساعة الحادية عشرة ليلاً وموعد المشرف صباح الغد. طالب ماجستير (مثال توضيحي لا يمثل شخصاً بعينه) قرّر تحليل استبيان بالذكاء الاصطناعي: رفع ملف فيه 30 إجابة إلى روبوت محادثة وكتب «حلّل لي النتائج». بعد ثوانٍ وصله جدول أنيق وفقرة تفسير تبدو أكاديمية. السؤال الذي لم يطرحه على نفسه: من أين جاءت هذه الأرقام فعلاً؟ وهل سيعيد الرقم نفسه إذا سأله اللجنة بعد أسبوع؟
الجواب المختصر: تحليل استبيان بالذكاء الاصطناعي ممكن ومفيد إذا استخدمته في التخطيط والشرح لا في الحساب. صمّم الأداة وراجعها معه، وجهّل البيانات، واطلب خطة اختبارات، ثم احسب الأرقام في SPSS أو jamovi أو R، وأخيراً تحقق من كل رقم وأفصح عن الاستخدام. ألفا كرونباخ واختبارات الدلالة مكانها برنامج إحصائي.
في هذا المقال خمس خطوات مرتبة، وست رسائل عربية جاهزة للنسخ، ومثال محسوب فعلاً على بيانات توضيحية يريك كيف يغيّر خطأ واحد (عبارة سلبية لم تُعكس) قرار «هل الأداة ثابتة؟» بالكامل. ستجد أيضاً جدولاً بما تقبله لجنة المناقشة وما لا تقبله، وجدولاً آخر يحدد متى تكفيك أداة الذكاء الاصطناعي ومتى لا بد من SPSS.
ما الذي يستطيعه الذكاء الاصطناعي في الاستبيان وما الذي لا يستطيعه؟
نماذج اللغة ممتازة في اللغة: تراجع صياغة العبارات، وتشرح مفهوماً إحصائياً بلغة بسيطة، وتقترح بنية لجدول الترميز، وتحوّل جدولاً جاهزاً إلى فقرة مقروءة. أما ما يحتاج دقة عددية قابلة للتحقق (ألفا كرونباخ، قيمة p، درجات الحرية) فهنا يقع الخطر، لأن النموذج يولّد نصاً محتملاً ولا يشغّل بالضرورة عملية حسابية على ملفك.
الأدلة المنشورة تدعم هذا الحذر. دراسة Ouyang وزملائه على ChatGPT في توليد الأكواد (سياق برمجي لا إحصائي، ونذكره بصراحة) وجدت أن نسبة المهام التي لم يُنتج النموذج فيها أي مخرجات اختبار متطابقة عبر الطلبات المتكررة بلغت 75.76% و51.00% و47.56% في ثلاث مجموعات اختبار مختلفة، وأن ضبط درجة العشوائية (temperature) على صفر «لا يضمن الحتمية». ودراسة Atil وزملائه (5 نماذج، 8 مهام، 10 تشغيلات لكل مهمة) سجّلت تغيّراً في الدقة يصل إلى 15% بين تشغيل وآخر لنفس الطلب، وخلصت إلى أن لا نموذج منها أعطى دقة قابلة للتكرار في كل المهام. أما مسح Ji وزملائه المنشور في ACM Computing Surveys فيقرر أن التوليد المبني على التعلم العميق «عرضة لإنتاج نص غير مقصود» أي ما يسمى الهلوسة.
لا يعني هذا أن الأداة عديمة النفع. يعني أن تضعها في المكان الصحيح. أوضح تقسيم منشور هو إطار Springer Nature الذي يصنف استخدامات الذكاء الاصطناعي في البحث إلى ثلاث درجات، وهذه الصفوف المتعلقة بالبيانات منه:
| المهمة | تصنيف Springer Nature | معناها لتحليل استبيانك |
|---|---|---|
| تنظيف البيانات وكشف التكرار | أخضر | استخدام منخفض المخاطر، وثّق ما فعلته |
| مقارنة الخيارات المنهجية | أخضر | اسأل عن الفروق بين الاختبارات ثم قرّر أنت |
| اقتراح اختبارات إحصائية أو نماذج | أصفر | مسموح بإشراف بشري وتحقق وإفصاح |
| شرح مخرجات النماذج الإحصائية بلغة بسيطة | أصفر | مسموح بإشراف وإفصاح، راجع كل رقم |
| اكتشاف الأنماط في التحليل الاستكشافي | أصفر | مسموح بإشراف وإفصاح |
| اختلاق بيانات أو مراجع أو نتائج | أحمر | مرفوض |
| تقديم فرضيات أو تحليلات أو استنتاجات على أنها من عمل الباحث | أحمر | مرفوض |
هذه سياسة ناشر لا لائحة جامعتك، لكنها تعطيك الحد الفاصل الذي تتفق عليه معظم السياسات: المسؤولية عن المحتوى العلمي لا تُفوَّض للأداة. وتقول Springer Nature نصاً إن المساءلة عن المحتوى العلمي «لا يمكن تفويضها لأنظمة الذكاء الاصطناعي». وبعبارة ICMJE: روبوتات المحادثة لا تُدرج مؤلفةً، و«البشر مسؤولون عن أي مادة مقدمة استُخدمت فيها أدوات ذكاء اصطناعي».
المثال الذي سنحسبه: استبيان توضيحي من 30 مستجيباً
لكي لا يبقى الكلام نظرياً، اعتمدنا في هذا المقال مثالاً توضيحياً. هذه بيانات اصطناعية ولّدناها لغرض الشرح، وليست دراسة حقيقية ولا إجابات مشاركين، ولا تُنسب لجامعة أو باحث. الغرض منها أن تكون الأرقام قابلة للتحقق: حُسبت كلها من ملف CSV واحد بسكربت بايثون، وراجعنا ألفا بصيغة ثانية (مصفوفة التغاير) فتطابقت القيمتان، وراجعنا قيمة p لاختبار t باختبار تبديل من 20,000 تبديلة فجاءت قريبة كما يُتوقع. لم نشغّل SPSS نفسه هنا، لكن الصيغ قياسية فيُتوقع أن يطابق ناتجه هذه الأرقام.
وصف المثال: استبيان «الرضا عن التعلم» من 6 عبارات بمقياس ليكرت الخماسي (1 = لا أوافق بشدة، 5 = أوافق بشدة). المستجيبون 30: 15 طالباً يدرسون حضورياً و15 يدرسون عن بعد. العبارات من Q1 إلى Q5 إيجابية الصياغة. العبارة السادسة Q6 سلبية الصياغة (مثل «أشعر بالملل أثناء المحاضرات») فالقيمة العالية فيها تعني رضاً أقل، وتحتاج عكساً بالمعادلة 6 − القيمة قبل التجميع. وهذا من أكثر الأخطاء شيوعاً في الفصل الرابع.
الجدول الآتي هو الملخص «الآمن» الذي يمكن لصقه في أداة ذكاء اصطناعي: لا صفوف مستجيبين ولا أي معلومة تعريفية.
| العبارة | المتوسط | الانحراف المعياري | ملاحظة |
|---|---|---|---|
| Q1 | 3.667 | 0.959 | إيجابية |
| Q2 | 3.700 | 0.794 | إيجابية |
| Q3 | 3.567 | 0.774 | إيجابية |
| Q4 | 3.500 | 0.974 | إيجابية |
| Q5 | 3.533 | 0.937 | إيجابية |
| Q6 (بعد العكس) | 3.733 | 0.785 | معكوسة بالمعادلة 6 − x |
خذ متوسط Q6 قبل العكس كما هو مخزّن في الملف: 2.267. فرق واضح عن 3.733، ويكفي لتفهم لماذا يتحول التحليل إلى فوضى إذا لم يعرف أحد أن العبارة سلبية.
الخطوة 1: صمّم الأداة وراجعها قبل أي تحليل
أفضل مكان لاستثمار الذكاء الاصطناعي هو قبل جمع الإجابات. تصميم استبيان بالذكاء الاصطناعي مقبول إذا بقي دوره مراجعة لغوية ومنهجية، أما بناء المقياس نفسه فمسؤوليتك: لكل عبارة فرضية، ولكل فرضية متغير، ولكل متغير مقياس واضح. ولا تدخل نماذج Google Forms قبل أن تكون هذه الخريطة جاهزة، وإن أردت تفاصيل بناء النموذج الإلكتروني وتصدير الإجابات فراجع تصميم استبيان إلكتروني للبحث العلمي.
المصدر: Google Workspace
ما الذي تطلبه من الأداة في هذه الخطوة؟ ثلاثة أشياء فقط: كشف العبارة ذات الشقين («المحاضرات واضحة وممتعة» عبارة واحدة تسأل عن شيئين)، وكشف الإيحاء بالإجابة («ألا توافق على أن التعلم عن بعد ضعيف؟»)، وكشف الغموض. وحدّد منذ الآن العبارات سلبية الصياغة لأنك ستعكسها لاحقاً، وهذا ما تفعله الرسالة الثانية.
الرسالة الأولى: مراجعة عبارات الاستبيان. انسخها، واستبدل ما بين « » بمعلوماتك:
أنا طالب ماجستير أصمّم استبياناً عن «موضوع الدراسة» لعينة من «الفئة المستهدفة». هذه عبارات المحور الأول بمقياس ليكرت الخماسي:
«الصق العبارات هنا»
راجع كل عبارة لغوياً ومنهجياً: هل فيها شقّان في عبارة واحدة؟ هل فيها إيحاء بالإجابة؟ هل فيها غموض؟ ثم اقترح صياغة بديلة لكل عبارة إشكالية مع سبب موجز. لا تضف عبارات جديدة ولا تخترع مقياساً.
الرسالة الثانية: جدول الترميز والعبارات العكسية.
هذه عبارات استبياني ومقياسها (1 = لا أوافق بشدة، 5 = أوافق بشدة):
«العبارات مرقّمة Q1 إلى Qn»
أنشئ جدول ترميز بالأعمدة: اسم المتغير، نص العبارة، نوع القياس، هل العبارة سلبية الصياغة وتحتاج عكساً؟ (نعم أو لا) مع سبب. لا تحلّل أي بيانات.
انتبه إلى الجملة الأخيرة في كل رسالة: «لا تحلّل أي بيانات». تقييد المهمة بوضوح يقلل فرصة أن يتطوع النموذج بأرقام لم تطلبها. وراجع بنفسك جدول الترميز الذي يعطيك إياه، فقد يخطئ في تصنيف عبارة سلبية، وخطأ كهذا لا يُكتشف إلا بقراءتك.
الخطوة 2: جهّل الهوية وقرّر ما يُرفع وما لا يُرفع
قبل أن تلصق أي شيء في أداة ذكاء اصطناعي اسأل: ما الذي وافق عليه المشاركون؟ نموذج الموافقة الذي وقّعوه أو أقرّوه، وموافقة لجنة الأخلاقيات في جامعتك إن وُجدت، هما المرجع، وغالباً لا يتضمنان رفع إجاباتهم إلى خدمة خارجية. لذلك القاعدة الأسلم: لا ترفع ملف الإجابات. ارفع ملخصات وبنية الأعمدة.
| ما تريد رفعه | الحكم | السبب |
|---|---|---|
| ملف الإجابات الخام فيه أسماء أو بريد أو هاتف أو جامعة دقيقة | لا | بيانات شخصية، وهي ما تمنعه سياسات النشر على الأنظمة العامة |
| إجابات ليكرت بمعرّف R01 وما بعده، بلا أي بيانات تعريفية | يحتاج موافقة | الأفضل الاكتفاء بالملخص ما لم تسمح لجنتك |
| جدول ملخص (متوسط وانحراف لكل عبارة) | نعم | لا يمكن ربطه بشخص |
| نص عبارات الاستبيان | نعم | هذه أداتك لا بيانات المشاركين |
| بنية الأعمدة (اسم المتغير، النوع، الترميز) | نعم | وصف للبيانات لا بيانات |
| إجابات الأسئلة المفتوحة النصية | لا | قد تكشف هوية صاحبها بتفاصيل عابرة |
| جدول ناتج من SPSS بلا بيانات خام | نعم | هذا ما سنطلب شرحه |
ويدعم هذا التحفظ ما تقوله شروط المنصات نفسها، وقد قرأنا الصفحات الآتية في نوفمبر 2026:
- Springer Nature: المخطوطات وتقارير التحكيم والبيانات الحساسة «يجب ألا تُشارك مع أنظمة ذكاء اصطناعي غير آمنة أو عامة».
- Anthropic، الخطط الاستهلاكية (Free وPro وMax): تُستخدم محادثاتك لتحسين النماذج إذا اخترت السماح بذلك، وتُستثنى محادثات وضع التخفي (Incognito). أما المنتجات التجارية فالأصل أنها لا تستخدم مدخلاتك ومخرجاتك للتدريب.
- OpenAI عبر واجهة API: البيانات المرسلة إليها لا تُستخدم لتدريب النماذج أو تحسينها منذ 1 مارس 2023 ما لم تشترك طوعاً، مع الاحتفاظ بسجلات إساءة الاستخدام لمدة تصل إلى 30 يوماً. لم نتمكن من قراءة سياسة نسخة ChatGPT الاستهلاكية، لذلك لا نقول عنها شيئاً.
أي أن السياسات تختلف بين خطة وأخرى وتتغير. اقرأ شروط الخطة التي تستخدمها فعلاً قبل أن تلصق أي معلومة عن مشاركين، وإذا لم تكن متأكداً فاستعمل الملخص ولا شيء غيره.
الخطوة 3: اطلب خطة تحليل لا نتائج
هنا يصبح الذكاء الاصطناعي مفيداً حقاً. أعطه وصف متغيراتك وفرضياتك، لا بياناتك، واسأله: أي اختبار يناسب؟ لماذا؟ وما الافتراضات التي يجب فحصها؟ هذا يوفر عليك ساعات من القراءة، وهو بالضبط ما تضعه Springer Nature في الفئة الصفراء: اقتراح الاختبارات الإحصائية مسموح بإشراف بشري وإفصاح.
الرسالة الثالثة: اختيار الاختبار المناسب دون بيانات.
فرضيتي: «نص الفرضية». المتغير التابع: درجة مقياس رضا (متوسط 6 عبارات ليكرت 1-5). المتغير المستقل: «مجموعتان مستقلتان أو ثلاث مجموعات أو متغير مستمر». حجم العينة: «N» (حوالي «n1» و«n2» في المجموعتين).
اقترح الاختبار المناسب ولماذا، وما الافتراضات التي أتحقق منها في SPSS، وما البديل اللامعلمي إن لم تتحقق. اشرح الخطوات في SPSS بالقوائم. لا تحسب أي نتيجة ولا تفترض أرقاماً.
في مثالنا ستكون الإجابة المنطقية: اختبار t لعينتين مستقلتين (حضوري مقابل عن بعد)، مع فحص تجانس التباين واعتدالية الدرجة، والبديل مان-ويتني إذا لم تتحقق الافتراضات. لكن لا تكتفِ بقبول الاقتراح. اسأل نفسك: هل نوع المتغير ومستوى قياسه وحجم العينة يبرران هذا الاختيار؟ اللجنة ستسأل «لماذا هذا الاختبار» وجواب «لأن الذكاء الاصطناعي اقترحه» ليس جواباً. اربط الجواب بنوع المتغير وتوزيع الدرجات.
وللتفصيل في الخطوات الكاملة داخل البرنامج، يشرحها المقال المنفصل تحليل استبيان SPSS خطوة بخطوة.
الخطوة 4: احسب في برنامج إحصائي ثم اطلب الشرح
هذه الخطوة هي قلب المقال: الأرقام تخرج من البرنامج، والشرح يأتي من النموذج. لدينا ثلاثة خيارات معروفة: SPSS المدفوع الذي تطلبه كثير من الجامعات، وjamovi المجاني المفتوح المصدر، ولغة R. أي منها يعطيك رقماً قابلاً لإعادة الإنتاج من ملف البيانات، ويمكنك تسليم ملف المخرجات للمشرف.
بالنسبة لمثالنا، هذه الخطوات في SPSS:
- اعكس العبارة السلبية: من قائمة Transform اختر Compute Variable، وسمّ المتغير الجديد Q6_rev، واكتب المعادلة 6 - Q6_raw.
- احسب الثبات: من قائمة Analyze اختر Scale ثم Reliability Analysis، وأدخل Q1 إلى Q5 وQ6_rev، واختر النموذج Alpha. في نافذة Statistics فعّل خيار Scale if item deleted لترى أثر حذف كل عبارة.
- كوّن درجة المقياس: متوسط العبارات الست في متغير جديد (الدالة MEAN).
- اختبر الفرق بين المجموعتين: من Analyze اختر Compare Means ثم Independent-Samples T Test، والمتغير الفاصل هو المجموعة.
وإن فضّلت لغة الأوامر (Syntax) لأنها تحفظ خطواتك كاملة وتعيد إنتاجها:
COMPUTE Q6_rev = 6 - Q6_raw.
EXECUTE.
RELIABILITY /VARIABLES=Q1 Q2 Q3 Q4 Q5 Q6_rev
  /SCALE('Satisfaction') ALL
  /MODEL=ALPHA
  /SUMMARY=TOTAL.
COMPUTE satisf = MEAN(Q1,Q2,Q3,Q4,Q5,Q6_rev).
EXECUTE.
T-TEST GROUPS=group(1 2)
  /VARIABLES=satisf
  /CRITERIA=CI(.95).
افترضنا هنا ترميز المجموعتين بالقيمتين 1 و2. وقد تختلف أسماء القوائم قليلاً بين إصدارات SPSS، كما أن الإصدارات الأحدث تعرض حجم الأثر في جدول مستقل، وإن لم يظهر في إصدارك فيُحسب يدوياً أو بأداة مساعدة.
هذه أصعب خطوة في الدليل لمن لم يستخدم SPSS من قبل: اختيار الاختبار الصحيح للفرضيات وأنواع المتغيرات، وتنظيف الملف، ثم قراءة المخرجات. إن أردت أن يتولاها محلل يشغّل SPSS على بياناتك ويسلمك الجداول مع التفسير، فهذه خدمة التحليل الإحصائي للاستبيانات باستخدام SPSS من قدّملي.
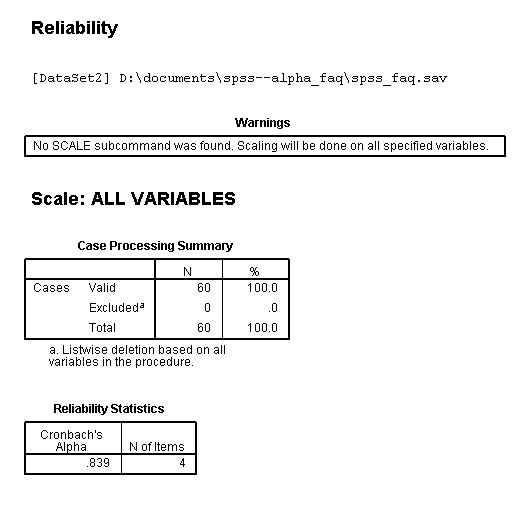
بعد أن يخرج الناتج من البرنامج، تعود إلى الأداة بطلب الشرح فقط. الصق جدول الثبات من SPSS (لا الملف الخام):
المصدر: UCLA OARC، مركز الإحصاء بجامعة كاليفورنيا لوس أنجلوس
الرسالة الرابعة: شرح جدول ألفا كرونباخ.
هذا ناتج Reliability Statistics من SPSS (بلا بيانات خام):
«الصق: Cronbach's Alpha ثم N of Items ثم جدول Item-Total Statistics»
اشرح لي بالعربية البسيطة: ماذا تعني القيمة؟ هل توجد عبارة مشكلة (ارتباط معدّل بالمجموع منخفض أو سالب)؟ وهل يوحي ذلك بعبارة سلبية لم تُعكس؟ استخدم الأرقام الموجودة في الجدول فقط، وإن لم يكفِ الجدول لقول شيء فقل ذلك صراحة.
الرسالة الخامسة: فقرة التفسير من جدول جاهز.
هذا جدول نتائج اختبار t لعينتين مستقلتين نسخته من SPSS:
«الصق الجدول: المتوسطات، الانحرافات، t، df، p، فاصل الثقة، حجم الأثر»
اكتب فقرة من 80 إلى 100 كلمة بالعربية الأكاديمية تفسّر النتيجة بأسلوب APA 7. التزم حرفياً بالأرقام الموجودة في الجدول، ولا تضف رقماً غير موجود، ولا تقل «دالة» إلا إذا كانت p أقل من 0.05 في الجدول. إن كانت النتيجة غير دالة فاذكر ذلك مع حجم الأثر وفاصل الثقة.
لاحظ كيف صيغت الرسالة: تمنع النموذج من إضافة رقم، وتمنعه من وصف النتيجة بالدلالة إلا إذا ثبتت بالجدول. تكرار القيود هذا ليس مبالغة، فالنماذج تميل إلى تحسين الصياغة على حساب الدقة.
ما الذي يحدث فعلاً: الحساب الصحيح مقابل خطأ واحد
الآن نقارن. عمود «بلا عكس» يعرض الناتج الحقيقي لخطأ محدد تمام التحديد: تجميع Q6 كما هي دون عكس. هو لا يمثل ناتج أداة ذكاء اصطناعي بعينها، ولم نجرب نموذجاً لغوياً لنسجل ناتجه. هو مثال على ما يحدث حين يُحلَّل الجدول دون أن يعرف أحد أن عبارة سلبية الصياغة مخزنة بقيمتها الخام. وكل رقم في العمودين حُسب من الملف نفسه.
| البند | بلا عكس Q6 (خطأ) | مع عكس Q6 (الصحيح) |
|---|---|---|
| ألفا كرونباخ (6 عبارات) | 0.644 | 0.901 |
| ارتباط Q6 المعدّل بالمجموع | −0.737 | +0.737 |
| ألفا إذا حُذفت Q6 | 0.883 | لا ينطبق، فالعبارة سليمة |
| متوسط الحضوري | 3.511 | 3.822 |
| متوسط عن بعد | 3.233 | 3.411 |
| فرق المتوسطين | 0.278 | 0.411 |
| اختبار t لعينتين مستقلتين | t(28) = 1.479، p = .150 | t(28) = 1.617، p = .117 |
| فاصل الثقة 95% للفرق | من −0.107 إلى 0.662 | من −0.110 إلى 0.932 |
| حجم الأثر Cohen d | 0.540 | 0.590 (Hedges g = 0.574) |
| Welch | t(27.91) = 1.479، p = .150 | t(27.94) = 1.617، p = .117 |
ماذا نتعلم من هذا الجدول؟
أولاً، قرار الثبات انقلب. ألفا 0.644 أقل من 0.70 فتبدو الأداة غير ثابتة، وألفا 0.901 فتبدو ممتازة. السبب عبارة واحدة لم تُعكس. وتخيّل الخطأ التالي: من يرى «ألفا إذا حُذفت Q6 = 0.883» قد يقرر حذف العبارة السادسة وكأنها المشكلة، والمشكلة الحقيقية في الترميز لا في العبارة. العلامة الكاشفة هي الارتباط المعدّل بالمجموع السالب (−0.737)، وهذا بالضبط ما تطلب الرسالة الرابعة من النموذج أن ينتبه إليه.
ثانياً، العتبة 0.70 ليست كل شيء. تقول UCLA OARC إن القيمة 0.70 فأعلى «مقبولة في معظم مواقف البحث الاجتماعي»، لكنها تضيف تحذيرين مهمين: ألفا ليست اختباراً إحصائياً بل معامل ثبات واتساق، وارتفاعها لا يعني أن المقياس أحادي البعد، وأنك كلما زدت عدد العبارات ارتفعت ألفا. فلا تكتب في الفصل الرابع أن 0.901 «تثبت صدق الأداة»؛ هي مؤشر اتساق داخلي فحسب. وللتوسع في المعامل نفسه راجع معامل الثبات ألفا كرونباخ في SPSS، أو معامل الثبات بالتجزئة النصفية إن أردت طريقة بديلة.
ثالثاً، النتيجة غير دالة. مع العكس الصحيح p = .117، وهي أكبر من .05، وفاصل الثقة (من −0.110 إلى 0.932) يشمل الصفر. أما حجم الأثر d = 0.59 فمتوسط بمقاييس Cohen التقليدية، لكن العينة 15 في كل مجموعة، فالدراسة صغيرة لتكتشف فرقاً بهذا الحجم. الصياغة الصحيحة: «لم تظهر فروق دالة إحصائياً، مع حجم أثر متوسط وفاصل ثقة واسع». لا تكتب «توجد فروق دالة».
رابعاً، أكثر من اختبار يعطي أرقاماً مختلفة. على الدرجة المعكوسة نفسها: اختبار t وWelch يعطيان p = .117، ومان-ويتني يعطي U = 73.0 وZ = −1.646 وp = .0998 وحجم أثر r = 0.301 (تقريب طبيعي مع تصحيح الروابط)، واختبار التبديل يعطي p ≈ .124. كلها غير دالة، لكن الأرقام تختلف، واللجنة قد تسأل: أي اختبار استخدمت ولماذا؟ هذا السؤال لا يجيب عنه إلا من يفهم افتراضات الاختبار.
خامساً، الخطأ الصامت. لو حُسبت ألفا بقسمة تباين العبارات على N وتباين المجموع على N−1 (خلط شائع) لخرجت 0.911 بدل 0.901. فرق صغير يبدو مقنعاً ولا ينتبه إليه أحد، لكنه يمنعك من إعادة إنتاج الرقم عند أي مراجعة. هذا النوع من الأخطاء هو الثمن الحقيقي للحساب بلا برنامج.
وماذا لو سألت أداة ذكاء اصطناعي عن «قيمة p» وهي لا تملك ملف بياناتك؟ قد تعطيك قيمة تبدو متقنة دون أن تكون محسوبة من بياناتك. لا نعطي رقماً هنا عمداً، لأن الدرس هو أن الرقم المقنع لا يدل على أنه صحيح.
الخطوة 5: تحقّق وابنِ جداول APA ووثّق الاستخدام
آخر خطوة هي التي تحميك أمام اللجنة. لها ثلاثة أجزاء:
التحقق. طابق كل رقم وكل ادعاء في فقرة النموذج مع جدول البرنامج. إذا كتب النموذج «يثبت» أو «بوضوح» أو «يؤكد بشدة» فاحذف الكلمة ما لم تدعمها النتائج. وتقول APA إن عليك فحص مخرجات الذكاء الاصطناعي للتأكد من دقة المحتوى. وتساعدك الرسالة السادسة.
الرسالة السادسة: فحص الفقرة قبل التسليم.
راجع الفقرة التالية التي كتبتها لتفسير نتائجي مقابل الجدول المرفق:
«الفقرة»
«الجدول»
أعطني قائمة بكل رقم أو ادعاء في الفقرة غير موجود حرفياً في الجدول أو لا يمكن استنتاجه منه، وقائمة بأي مبالغة في اللغة (مثل «يثبت» أو «بوضوح») لا تدعمها النتائج. لا تعدّل الفقرة، فقط أشِر إلى المشاكل.
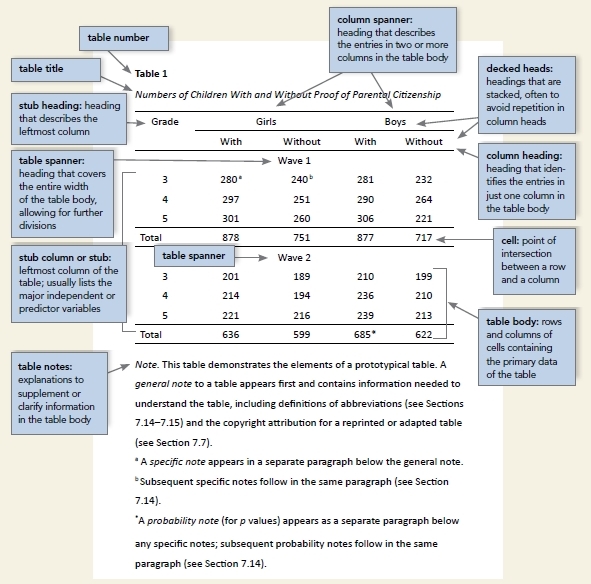
جداول APA. ابنِ الجدول بأداة الجداول في Word من الناتج الحقيقي ولا تلصق لقطة شاشة خام من SPSS. قواعد APA في الجداول: ترقيم الجداول بترتيب ذكرها في النص، ورقم الجدول بخط عريض وعنوانه مائل، وعدم استخدام حدود عمودية تفصل البيانات ولا حدود حول كل خلية. وللتفصيل في التوثيق نفسه راجع التوثيق APA 7.
المصدر: APA Style
الإفصاح والتوثيق. تنص APA في مدونتها المحدثة سبتمبر 2025 على أن الذكاء الاصطناعي نفسه لا يكون مؤلفاً لأنه ليس إنساناً واعياً، وأن الجهة المؤلفة في المرجع هي الشركة المطورة للأداة، وأن الرسائل (prompts) ليست جزءاً من المرجع بل تُوصف في النص أو في ملحق أو مادة إضافية. وتوصي بذكر الأداة في النص، وفي الغالب في قسم المنهج. وصيغة المرجع العامة: الشركة، السنة، اسم الأداة أو النموذج، ثم وصف النوع بين قوسين (large language model)، ثم رابط الأداة.
المصدر: APA Style
وهذه صيغة جاهزة للمنهجية يمكنك تعديلها بما يوافق لائحة جامعتك:
استُخدمت أداة ذكاء اصطناعي توليدي («اسم الأداة والإصدار»، «الشركة»، «السنة») في مراجعة الصياغة اللغوية لعبارات الاستبيان، وفي اقتراح الاختبارات الإحصائية المناسبة، وفي شرح المخرجات الإحصائية بلغة مبسطة. لم تُرفع إلى الأداة أي بيانات خام أو تعريفية عن المشاركين. أُجريت جميع الحسابات الإحصائية في برنامج «اسم البرنامج وإصداره»، وراجع الباحث كل رقم وكل تفسير ورد في الدراسة. تظهر الرسائل المستخدمة في الملحق «رقم الملحق».
واحتفظ بأربعة ملفات لإعادة الإنتاج: ملف البيانات (مثل .sav)، وملف المخرجات، وملف الأوامر (syntax) إن استخدمته، والرسائل كلها في الملحق. وإن أردت توثيق ما كتبه الذكاء الاصطناعي في نصوص أخرى من الرسالة، فسياسات الجامعات في نسبة الاقتباس والذكاء الاصطناعي موضوع مستقل تجده في نسبة الاقتباس من الذكاء الاصطناعي وتقرير Turnitin.
ما تقبله لجنة المناقشة وما لا تقبله
لوائح الجامعات تختلف، ولا يوجد مصدر واحد يحدد ما تقبله لجنتك بعينها. لذلك يعتمد الجدول الآتي على سياسات ناشرين كبار وجامعة منشورة، ويعبّر عن القاعدة العامة في السياسات المنشورة. راجع لائحة جامعتك ومشرفك قبل أي استخدام، ولا يقدّم هذا الجدول ضماناً بقبول أو رفض.
| الإجراء | الحكم | السبب أو المصدر |
|---|---|---|
| ألفا كرونباخ محسوبة من بيانات العينة في برنامج إحصائي مع ذكر N وعدد العبارات | مقبول | معامل ثبات واتساق، والعتبة 0.70 فأعلى مقبولة في معظم البحوث الاجتماعية (UCLA OARC) |
| رقم ألفا «تقديري» يعطيه نموذج لغوي من نص الجدول دون حساب | غير مقبول | غير قابل للتحقق، وهو من فئة اختلاق النتائج (Springer Nature)، ومخرجات الأدوات قد تكون خاطئة أو ناقصة أو متحيزة (ICMJE) |
| اقتراح اختبار إحصائي من الذكاء الاصطناعي ثم تبريره من الباحث بنوع المتغير والتوزيع | مقبول بشرط الإفصاح | فئة صفراء عند Springer Nature: مسموح بإشراف بشري وتحقق وإفصاح |
| قيمة p وdf وحجم الأثر منسوخة من ناتج SPSS أو jamovi أو R | مقبول | قابلة لإعادة الإنتاج من ملف البيانات، مثل t(28) = 1.617، p = .117 في مثالنا |
| قيمة p مأخوذة من نص نموذج لغوي دون برنامج | غير مقبول | عدم الحتمية: حتى مع temperature صفر لا تُضمن النتيجة نفسها (Ouyang وزملاؤه)، ودقة تتغير حتى 15% بين التشغيلات (Atil وزملاؤه) |
| تنظيف البيانات وكشف التكرار بمساعدة الأداة مع توثيق الخطوات | مقبول | فئة خضراء عند Springer Nature |
| شرح الناتج بلغة بسيطة بمساعدة النموذج ثم مراجعة الباحث لكل رقم | مقبول بإشراف وإفصاح | فئة صفراء عند Springer Nature، وتطلب APA فحص دقة مخرجات الأداة |
| نسخ فقرة التحليل كاملة من النموذج دون مراجعة | غير مقبول | الأدوات لا تُستخدم بديلاً عن التفكير النقدي والخبرة والتقييم البشري (Elsevier) |
| رفع ملف إجابات المشاركين الخام إلى أداة عامة | غير مقبول غالباً | البيانات الحساسة لا تُشارك مع أنظمة عامة (Springer Nature)، ويخالف عادة نموذج الموافقة، فاسأل لجنة الأخلاقيات |
| جداول APA 7 تُبنى بأداة الجداول في Word من ناتج حقيقي | مقبول | قواعد APA في الترقيم والحدود |
| لقطة شاشة خام من SPSS تُلصق كجدول في الفصل الرابع | غير مفضّل | استنتاج منا من قواعد APA التي تفترض جدولاً منسقاً لا صورة |
| بيانات استبيان مولّدة بالذكاء الاصطناعي تُقدَّم كأنها جُمعت من مشاركين | مرفوض قطعاً | اختلاق للبيانات (Springer Nature)، وهو مخالف للأمانة العلمية في كل مكان |
| ذكر الأداة في المنهجية ووضع الرسائل في ملحق | مقبول ومطلوب | توصية APA بذكرها في قسم المنهج، وتشترط Stanford توثيق أي استخدام والإفصاح عنه |
| استخدام الأداة حيث تمنعها سياسة المقرر أو المشرف | غير مقبول | سياسة Stanford (المعتمدة 15 أكتوبر 2026): عند غياب سياسة مكتوبة لا تُستخدم الأدوات لإنتاج مخرجات الدراسة، وسياسة المدرّس المكتوبة أولاً |
الصف الأخير مهم بوجه خاص. لا تقل «جامعتي تسمح» ولا «جامعتي تمنع» قبل أن تقرأ اللائحة بنفسك أو تسأل المشرف كتابةً. وإن كنت تستعد للمناقشة نفسها فراجع أسئلة لجنة المناقشة في رسالة الماجستير لتعرف نوع الأسئلة التي ستواجهها عن طريقة التحليل.
متى تكفي أداة الذكاء الاصطناعي ومتى تحتاج SPSS؟
| المهمة | هل تكفي أداة الذكاء الاصطناعي؟ | هل تحتاج برنامجاً إحصائياً؟ |
|---|---|---|
| مراجعة صياغة العبارات | نعم، مع مراجعتك | لا |
| جدول الترميز واقتراح العبارات العكسية | نعم | تحقق منه في البيانات |
| اختيار الاختبار المناسب | تقترح فقط | نعم للتنفيذ وفحص الافتراضات |
| ألفا كرونباخ وارتباط العبارة بالمجموع | لا | نعم |
| اختبار t وANOVA ومان-ويتني وكروسكال-واليس | لا | نعم |
| الانحدار والتحليل العاملي | لا | نعم |
| SEM والتحليلات المتخصصة | لا | نعم، وتحتاج خبرة خاصة |
| صياغة فقرة التفسير من جدول جاهز | نعم، مع مراجعة كل رقم | الجدول يأتي من البرنامج |
| تبسيط النتائج لعرض المناقشة | نعم | الأرقام من البرنامج |
قاعدة عملية تلخص الجدول: إذا كان الرقم سيُكتب في الفصل الرابع، فمصدره برنامج إحصائي. وإذا كان النص سيشرح الرقم، فيمكن للأداة أن تساعدك.
وماذا عن البدائل المجانية؟ jamovi وR يعطيانك ألفا واختبار t ومان-ويتني دون ترخيص مدفوع، وكثير من الجامعات تقبل أي برنامج إحصائي معروف ما دام مذكوراً في المنهجية. لكن بعض الأقسام تشترط SPSS تحديداً في دليلها، فاسأل أولاً. وبرنامج Excel أو Google Sheets يصلح للوصف البسيط (التكرارات والمتوسطات والرسوم) لا للثبات والاختبارات المعقدة إلا بإضافات وجهد كبير. وتصف IBM في صفحة منتجها أن SPSS Statistics يشمل الاختبارات الإحصائية والنمذجة التنبؤية، وأن فيه مساعداً لشرح المخرجات بلغة طبيعية؛ لكن هذا المساعد، شأنه شأن أي أداة، يُراجع ناتجه ولا يُكتب كما هو.
الأخطاء التي تتكرر عند استخدام الذكاء الاصطناعي في الاستبيان
- رفع الملف كاملاً: تضع بيانات مشاركين على منصة لم يوافقوا على مشاركتها.
- نسيان العبارات السلبية: كما رأينا، ألفا تنهار من 0.901 إلى 0.644 دون أن تتغير البيانات.
- كتابة «دالة» لأن الفرق يبدو كبيراً: مثالنا فرق 0.411 ومع ذلك p = .117.
- تصديق رقم لا تعرف مصدره: إن لم يكن الرقم في جدول من برنامج فهو غير موثق.
- تغيير الاختبار حتى تظهر الدلالة: المثال أعطى p بين .0998 و.150 حسب الاختبار، وكلها غير دالة. اختر الاختبار بناءً على الافتراضات قبل أن ترى النتيجة.
- إخفاء الاستخدام: الإفصاح لا يضعف عملك، بل يحميه.
- تعديل الإجابات لتحسين النتيجة: أي تعديل على بيانات جُمعت فعلاً مرفوض علمياً، سواء بيد الباحث أو بأداة.
قبل أن تذهب إلى المشرف: قائمة تحقق
- هل عكست كل العبارات سلبية الصياغة وراجعت ارتباط كل عبارة بالمجموع؟
- هل كل رقم في الفصل الرابع منسوخ من ناتج برنامج إحصائي أحتفظ بملفه؟
- هل ذكرت اسم الاختبار وسبب اختياره وفحصت افتراضاته؟
- هل كتبت النتيجة غير الدالة على أنها غير دالة، مع حجم الأثر وفاصل الثقة؟
- هل ما رفعته إلى أي أداة ملخص بلا بيانات تعريفية؟
- هل ذكرت الأداة في المنهجية ووضعت الرسائل في ملحق؟
- هل سألت مشرفي عن سياسة الجامعة المكتوبة في استخدام الذكاء الاصطناعي؟
أسئلة شائعة
هل يمكن تحليل استبيان رسالة الماجستير بالذكاء الاصطناعي بدل SPSS؟
لا بديلاً كاملاً. يمكنه مراجعة العبارات واقتراح الاختبارات وشرح الجداول، أما ألفا كرونباخ وقيم p وأحجام الأثر فاحسبها في SPSS أو jamovi أو R. السبب أن النماذج اللغوية غير حتمية: قد تتغير النتيجة بين تشغيل وآخر، فلا تصلح مصدراً لرقم تكتبه في الفصل الرابع.
كيف أحلل نتائج الاستبيان خطوة بخطوة؟
أنظف الملف وأرمّزه وأعكس العبارات السلبية، ثم أحسب الوصفيات وألفا كرونباخ ومعاملات الثبات، وأختار الاختبار المناسب لنوع المتغيرات وأفحص افتراضاته وأشغّله، ثم أبني جداول APA وأفسّرها وأحتفظ بملفات البيانات والمخرجات. هذه هي خطوات المقال نفسها، وتجد التفصيل داخل البرنامج في المقال المخصص لـ SPSS.
هل يقبل المشرف أو لجنة المناقشة تحليلاً ناتجاً عن الذكاء الاصطناعي؟
يختلف ذلك من جامعة إلى أخرى، ولا ضمان لقبول أي إجراء. القاعدة العامة في السياسات المنشورة أن الأرقام تأتي من برنامج إحصائي قابل للتحقق، وأن استخدام الأداة يُفصح عنه ويُراجع. اسأل مشرفك واقرأ لائحة جامعتك المكتوبة قبل أن تبدأ لا بعد أن تنتهي.
هل أرفع ملف إجابات المشاركين إلى ChatGPT أو Claude؟
الأسلم ألا ترفع الملف الخام. أزل الأسماء والبريد والهاتف، وارفع جدولاً ملخصاً أو بنية الأعمدة فقط، وراجع نموذج الموافقة ولجنة الأخلاقيات. شروط الخصوصية تختلف بين الخطط المجانية والتجارية وواجهات API وتتغير، فاقرأ شروط الخطة التي تستخدمها فعلاً قبل أي رفع.
كيف أحسب ألفا كرونباخ وما القيمة المقبولة؟
في SPSS: Analyze ثم Scale ثم Reliability Analysis، وأدخل عبارات المقياس بعد عكس السلبية منها. العتبة 0.70 فأعلى مقبولة في معظم البحوث الاجتماعية حسب UCLA OARC، لكن القيمة المرتفعة لا تثبت أحادية البعد، وتزيد بزيادة عدد العبارات. لا تحسبها بنموذج لغوي من نص الجدول أبداً.
هل يمكن تحليل الاستبيان في Excel أو Google Sheets بدل SPSS؟
يصلحان للوصف الأولي فقط: التكرارات والنسب والمتوسطات والرسوم البسيطة. أما ألفا كرونباخ واختبارات الفروق والانحدار فتحتاج غالباً إضافات أو معادلات يدوية معرضة للخطأ. البدائل المجانية الأنسب لرسالة جامعية هي jamovi وR، شرط أن تقبل جامعتك البرنامج المستخدم وأن تذكر اسمه وإصداره في المنهجية.
كيف أصمّم استبياناً بالذكاء الاصطناعي دون أن أضعف الصدق؟
ابنِ المقياس أنت بنفسك: فرضية ثم متغير ثم عبارات. استعن بالأداة في كشف العبارات ذات الشقين والإيحاء والغموض واقتراح صياغة بديلة، ثم جرّب الاستبيان على عينة استطلاعية صغيرة. لا تطلب منها اختراع مقياس، ولا تعتمد صياغتها قبل مراجعتك ومراجعة مشرفك.
هل يجب ذكر استخدام الذكاء الاصطناعي في المنهجية؟
نعم في الغالب. توصي APA بذكر الأداة في النص، وفي الأغلب في قسم المنهج، مع وصف الرسائل في الملحق، وتشترط Stanford توثيق الاستخدام والإفصاح عنه. ولا تُدرج الأداة مؤلفاً أبداً. الصيغة الجاهزة في الخطوة الخامسة تصلح نقطة بداية تعدّلها وفق لائحة جامعتك.
ماذا تفعل الآن؟
افتح ملف استبيانك واتبع الترتيب نفسه. ابدأ بجدول الترميز (الرسالة الثانية) وحدّد العبارات التي تحتاج عكساً قبل أن ترى أي نتيجة. ثم جهّز ملخصاً بلا بيانات تعريفية، واطلب خطة الاختبارات (الرسالة الثالثة)، ثم شغّل الحسابات في البرنامج الإحصائي الذي تقبله جامعتك. بعدها فقط اطلب الشرح (الرسالتان الرابعة والخامسة)، وراجع كل رقم (السادسة)، وأفصح عن الاستخدام.
وإذا ظهر لك في أي لحظة أن الأرقام لا تتطابق أو أن الاختبار غير واضح، فتوقف وراجع مشرفك. فرق ساعة في الأسبوع قبل المناقشة أرخص بكثير من اكتشاف الخطأ أمام اللجنة.
تريد من يتولى هذه الخطوة عنك؟
محلل يختار الاختبارات المناسبة لفرضياتك ونوع متغيراتك، ويشغّل SPSS على بياناتك كما هي، ويسلمك جداول جاهزة مع تفسير بلغة واضحة. التفاصيل والباقات في التحليل الإحصائي للاستبيانات باستخدام SPSS.
المصادر
- Springer Nature: سياسات التحرير في الذكاء الاصطناعي — إطار الاستخدام الأخضر والأصفر والأحمر وسياسة البيانات الحساسة.
- APA Style: توثيق مراجع الذكاء الاصطناعي التوليدي — المؤلف والمرجع والرسائل والملحق.
- APA Style: الجداول — ترقيم الجداول والحدود وعناصر الجدول.
- ICMJE: استخدام المؤلفين للذكاء الاصطناعي — المؤلف والمسؤولية.
- Elsevier: استخدام الذكاء الاصطناعي التوليدي في الكتابة — مسؤولية المؤلف وعدم الاستعاضة عن التفكير البشري.
- Stanford: إرشادات سياسة الذكاء الاصطناعي التوليدي — الافتراضي عند غياب سياسة مكتوبة والتوثيق والإفصاح.
- UCLA OARC: ماذا يعني ألفا كرونباخ؟ — تعريف المعامل وعتبة 0.70.
- OpenAI: بياناتك عبر واجهة API — الاستخدام في التدريب ومدة الاحتفاظ بالسجلات.
- Anthropic: هل تُستخدم بياناتي في التدريب؟ — الخطط الاستهلاكية والتجارية.
- Ouyang وزملاؤه: عدم حتمية ChatGPT في توليد الأكواد — نسب المهام ودرجة العشوائية صفر.
- Atil وزملاؤه: عدم حتمية إعدادات النماذج «الحتمية» — تغيّر الدقة بين التشغيلات.
- Ji وزملاؤه: مسح الهلوسة في توليد اللغة الطبيعية — تعريف الهلوسة في النماذج.
- IBM: صفحة منتج SPSS Statistics — وصف المنتج ومساعد شرح المخرجات.